人文情報学月報第181号
ISSN 2189-1621 / 2011年08月27日創刊
目次
- 《巻頭言》「歴史的資料デジタル化の10年の歩みと DH コミュニティの現在地」
:慶應義塾大学文学部 - 《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第97回
「古代文字資料と生成 AI:低資源古代言語における「不確実性」をめぐる AI4AS@DH2026での議論の報告」
:筑波大学人文社会系 - 《連載》「英米文学と DH」第20回
「文学と地図」
:中央大学国際情報学部 - 人文情報学イベント関連カレンダー
- イベントレポート「DH2026」
:東京大学/一般財団法人人文情報学研究所 - 編集後記
《巻頭言》「歴史的資料デジタル化の10年の歩みと DH コミュニティの現在地」
歴史的資料の OCR
前回、第60号[1]に巻頭言を書かせていただいてからちょうど10年が経ちました。本稿では、筆者の身の周りという狭い範囲にはなりますが、この10年の変化と国際的な DH 界における日本の立ち位置に関する所感を述べたいと思います。
第60号では、ヨーロッパの初期印刷本研究に関わるデータの状況について述べる中で、いわゆるひげ文字(ごつごつと角ばったゴシック体)の画像からの文字情報抽出、つまり OCR(Optical Character Recognition、光学的文字認識)の困難さを課題として挙げています。それから10年の間に、現代のテキストを対象とする OCR はスマートフォン(スマホ)に標準的な機能として付けられるほど日常的なものになりましたし、もちろん、歴史的資料の OCR も飛躍的な進展を見せています。さらに、活字体だけでなく、手書き文字の自動認識(Handwritten Text Recognition: HTR)の発展も目覚ましく、オーストリアのインスブルック大学で運用されている Transkribus や、フランスの PSL 研究大学による eScriptorium をめぐる動向は、本メールマガジンの読者にはなじみ深いでしょう。
欧米に比べ文字種が難しかった日本の古典籍についても、近年、国立国会図書館(NDL)などによる開発が急速に進んでいます。NDL古典籍 OCR や、一般的なノートパソコンでも動く軽量のNDL古典籍 OCR-Lite の公開により、江戸期以前の和古書や清代以前の漢籍などの古典籍の OCR が実用的かつ身近なものとなりました。ROIS-DS 人文学オープンデータ共同利用センター(CODH)による AI くずし字認識モデルを活用した無料のスマホアプリ「miwo(みを)」は、江戸時代の版本や古文書への間口を広げてくれています。デジタル画像化、OCR、文字データセット作成、それを学習データとして用いた AI モデル開発という良い循環が成立しつつあります。
大規模図書館などによる組織的なデジタルアーカイブではもちろんのこと、歴史的資料に関心がある人なら誰でも、個人でこうした課題に取り組める環境が整ってきました。これまでは主としてデータ作成段階の困難の解消に焦点が当たってきましたが、その公開や共有、保存、再利用が重要な課題になってきています。世界的なオープンサイエンスの流れの中、この流れは一層強まっていくでしょう。
2026年夏の DH 関連学会と日本からの参加状況
この夏に、筆者は DH 関連の国際学会に2つ参加しました。詳細はイベントレポートに譲り、ここでは日本からの参加状況をご報告します。7月末には、韓国の大田市において国際デジタル・ヒューマニティーズ学会連合(ADHO)の年次学術大会である DH2026が対面およびオンラインで開催されました。公開された抄録集は1000ページを超え、コンピュータを活用した文学作品研究といった蓄積のあるテーマから AI を組み込んだパイプラインの提案まで、幅広い DH 分野の熱気が伝わってきます[2]。索引を見ると、日本を活動の場としている研究者が多数発表していることがわかります。さらに、本会議前のワークショップやミニカンファレンスで発表したため氏名が掲載されていない研究者(筆者もその一人ですが、希望者は抄録集の version 2に収録されるようです)、発表こそしないものの情報の収集や交換のための参加者も含めると、日本からは対面・オンラインあわせて50人以上の参加があったことになります。
8月中旬にカナダのブリティッシュ・コロンビア大学で開催された TEI コンソーシアムの年次学術大会である TEI2026にも、全体の参加者数が75人(これは事前登録者数のため、実際にはもう少し多かったと思われます)と例年よりも小規模であったなか、日本の諸機関からは10人の発表者があり、存在感を発揮していました[3]。この活発な研究状況の背景には、2016年に TEI 東アジア/日本分科会(SIG EAJ)を設立し、TEI の普及に努めてきた方々の活動があることを考えると頭が下がります。一部の参加者はDH2026とも重なり、人文学領域の研究データを共有、再利用しやすい形で構造化することへの関心の強さがうかがえます。
こうした学会では、日頃の研究者仲間だけでなく、年齢を問わず新たに DH 領域に加わった研究者や、国や組織は違えど関心や課題を共有する研究者と新たに知り合ったり、共同研究の契機が芽生えたりと、さまざまな出会いが生じていました。まさに学会のインフォーマルコミュニケーションとしての大事な側面であるといえます。また、図書館・情報学専攻に身をおく筆者としては、欧米からは図書館職員の参加・発表が活発であることも印象的でした。国により図書館職員の職制は異なりますが、文化遺産を所蔵し公開している組織として研究の大事なパートナーであることは同じですから、日本でも図書館をはじめとする GLAM からの参加者が増えるような工夫の必要性が感じられました。研究成果やそれに用いたデータやツール、コードをオープンアクセスで公開するという動向は広く見られ、研究領域のさらなる発展が期待されるところですが、一方ではそうした状況で会費を払う個人および機関の会員数をいかに維持するかという、世界共通の課題も垣間見えました。
9月中旬には日本デジタル・ヒューマニティーズ学会の年次学術大会 JADH2026が九州大学を会場にハイブリッド開催され、日本内外からの多岐にわたる発表が行われる予定です[4]。上述の学会に参加して刺激を受けられた方にとっても、今回は参加がかなわなかった方にとっても、JADH2026が活発な研究交流の場となることが期待されます。
これからの10年に向けて
変化が速いこの領域において、将来的な展望を語ることは筆者の手に余ります。とはいえこれからの10年に向けた期待を述べて本稿を締めくくりたいと思います。
AI を含む技術的な進展は今後も加速していくでしょう。そうした状況において、人文学の役割を考えていく際には、コミュニティが重要になると思われます。日本全体で見れば、名称や組織化の度合いはさまざまながら、DH 関連の教育や研究は年々さかんになっています。2024年には文科省委託事業「人文学・社会科学の DX 化に向けた研究開発推進事業」として DH コンソーシアムが立ち上がり、慶應義塾大学も日本・東アジアテキストの研究データ基盤を構築するハブとなっています[5]。こうしたコンソーシアムや、本メールマガジンの発行主体である人文情報学研究所などにより、国内の DH 研究・教育に携わる諸機関が一同に会して情報と知見を交換する機会が定期的に設けられ、DH コミュニティ形成・強化にとって重要な機会となっています。こうした場で育まれてきたつながりをどのように活かし、また次世代に継承していくべきか、DH に関わる一人一人が考えていかなければなりません。
2027年には TEI2027を慶應義塾大学にて開催します。TEI 年次大会は2018年にも東京で JADH との共催のもとに行われているので、日本ではほぼ10年ぶりということになります。航空券高騰の折、日本にいながらにして国際学会で発表、参加できる貴重な機会ですから、ぜひ今からご予定ください。これが日本国内の、また国際的な DH コミュニティのさらなる強化につながることを願っています。
執筆者プロフィール
《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第97回
「古代文字資料と生成 AI:低資源古代言語における「不確実性」をめぐる AI4AS@DH2026での議論の報告」
はじめに
2026年7月27日、韓国・大田で開催されたDigital Humanities 2026(DH2026)のミニカンファレンスの一つとして、AI4AS 2026(Artificial Intelligence for Ancient Scripts)がオンラインと対面で同時開催された。 今回は、筆者も運営に参加した AI4AS 2026について、古代語文献学と生成 AI との関係という観点から紹介したい[1]。
AI4AS 2026のテーマは「Artificial Intelligence, Engagement, and the Fragility of Ancient Scripts」である。近年、生成 AI によって、専門的な言語訓練を必要とする古代文字資料の翻訳や要約にも容易にアクセスできるようになった。その一方、古代語は一般にデータ量が少なく、碑文、パピルス、オストラカ、写本には欠損や異読も多い。AI がそのような曖昧さを、現代語として自然で首尾一貫した一つの解釈にまとめてしまうことは、古代語の文献学にとって大きな問題となる。AI4AS では、この問題を翻訳、文字・画像認識、文献学、教育という複数の側面から検討した。
運営委員会には、Chiara Salvador 氏(モンペリエ・ポール=ヴァレリー大学)、Angelica Lo Duca 氏と Andrea Marchetti 氏(イタリア国立研究評議会情報通信工学研究所)、Shai Gordin 氏(アリエル大学)、Sebastian Nehrdich 氏(東北大学)、そして筆者が参加した[2]。
「創造的すぎる」AI
基調講演は Richard Sproat 氏(Sakana AI)による「AI Creativity Where It’s Too Easy to Be Creative: Using LLMs to Detect Puns and Allusions in Heraldry」であった。 欧州の紋章や日本の家紋には、家名を図像で暗示したり、家名と図像の間に音韻的な駄洒落を作ったりする例がある。Sproat 氏は、こうした関係を LLM のマルチエージェントによる討論を利用して検出する実験を紹介した [3]。
興味深かったのは、曖昧な例になるほど LLM が「創造的」になり、人間なら通常想定しないような音韻関係や語源的関係まで提示する点である。もっともらしい説明が生成されたからといって、それを裏付ける文献学的証拠が存在するとは限らない。その後の議論につながる問題提起であった。
翻訳と不確実性
第1セッションは「AI and Translations: Interpreting Uncertain and Ambiguous Data」であった。 Yael Assouline 氏(アリエル大学)は、ギリシア語魔術パピルスに現れる historiolae を LLM によって検出・注釈する研究を報告した。ここでは、何を一つの物語単位として切り出すのかという分節自体が研究者の判断を必要とする。
Gunhyuk Lee 氏(中央ヨーロッパ大学)は、O.Frange 1–27のコプト語オストラカを生成 AI に読ませ、その出力を分析した。定型表現の多い書簡は AI が比較的処理しやすい一方、欠損箇所や人物関係を補い、断片的な文章を自然な物語として再構成する場合がある。Doaa Elalfy 氏(エルサレム・ヘブライ大学)は、ギリシア語―アラビア語医学文献を例に、原文と翻訳の対応が必ずしも一対一ではないにもかかわらず、AI が整然とした対応関係を作り出す問題を扱った。
一方、Greg Baker 氏ら(マッコーリー大学ほか)の「Into the Parallage」は、一つの「正しい」AI 翻訳を求めず、多数の翻訳を生成し、それらが一致する箇所と分岐する箇所を調べるという発想を提示した。出力が大きく分かれる箇所を、人間の研究者が再検討すべき場所として利用するのである。AI を文献上の不確実性を発見する道具として用いる発想である。
セッション後の討論では、文化・言語的文脈、複数の本文伝承、人間の責任、AI リテラシーなどが話題となった。AI が曖昧さを平板化しないこと、特定の校訂版を暗黙の「原文」としないこと、最終的な責任を研究者が負うことなどが論点となった。
文字・画像、そして文献学教育
第2セッション「AI and Graphic Elements」では、文字や図像、古書体が取り上げられた。 Celia López Castillo 氏(セビリア大学)と David Díez Galindo 氏(サラゴサ大学)は、東アジアの文字・図像資料を用いて、生成 AI が未知の形を既知の文字や図像に過度に結び付ける問題を検討した。Isabelle Marthot-Santaniello 氏(バーゼル大学)は、古代ギリシア語パピルスの古書体学とコンピュータビジョンの約8年間にわたる共同研究を振り返り、データセット作成、画像前処理、エラー分析などの各段階で、人文学者と情報学者との継続的な対話が必要であることを指摘した。
午後の第3セッション「AI and Philological and Educational Practices」では、筆者と Nehrdich 氏が司会を担当した。 Eva Maria Hemauer 氏(ベルリン・フンボルト大学/ミュンヘン大学)は、古代エジプト語の諸段階と象形文字ルウィ語を比較し、翻字方式によって LLM の性能が変化することを示した。翻字は単なる機械的な前処理ではなく、それ自体が研究者による解釈を含む。入力データ自体が中立ではないのである。
Alexandre Loktionov 氏ら(ロシア国立研究大学高等経済学院、ケンブリッジ大学ほか)は、ヒエログリフ学習を支援する human-in-the-loop 型 AI について報告した。AI は文字同定などを助ける一方、その回答を検証するという別の認知負荷を生み、使い方によっては学生が習得すべき文献学的技能を AI に委ねる可能性もある。Shuning Zhang 氏(筑波大学)は、満洲語―漢文対訳データベースを例に、OCR、注釈、検索などに AI を導入しながら、人間による検証を研究工程の中心に残す方法を紹介した。
このセッション後の討論では、AI 利用の透明性、AI を「助手」として位置付けること、学際的協働などが話題となった。AI を使った箇所を明示することに加え、AI によって他分野の専門家との対話そのものを省略しないことも重要である。
おわりに
最後には「Towards Responsible AI for Low-Resource Ancient Languages」と題した共同ワークショップが設けられ、事前に準備されていた10のベスト・プラクティス原則について参加者が検討した。 会議前に共有文書へ寄せられた意見や、各セッションで出された論点を参照しながら、低資源古代言語に AI を利用する際に何を守るべきかを共同で考える試みであった。AI4AS の公式サイトでも、アクセシビリティを高めながら文献学的厳密さを維持し、文献学・碑文学・歴史言語学の解釈伝統を AI が支援するためのベスト・プラクティスを作ることが会議の目的として掲げられている [4]。
今回の AI4AS 2026を通して特に興味深く感じたのは、「AI は古代語をどの程度読めるのか」という性能評価だけでなく、「古代文献が本来もっている不確実性を AI でどのように扱うのか」が大きな問題になっていたことである。欠損、多義性、異読、分節の揺れ、写本間の差異などは、文献学では単に取り除けばよいノイズではない。むしろ、それらを記録し、複数の可能性を比較すること自体が重要な作業である。
生成 AI は、こうした不確実な情報を一つの自然な文章にまとめることを得意としている。しかし古代文献学では、その「自然さ」がかえって問題になる場合がある。今後は、AI に最終的な読みを決めさせるのではなく、複数の候補を提示させたり、解釈が不安定な箇所を発見させたりする方向での利用がより重要になると思われる。古代文献学が長年培ってきた、曖昧な証拠を曖昧なまま記述し検討する方法と、生成 AI をどのように組み合わせていくのか。AI4AS 2026は、そのことを考える上で興味深い機会となった。
《連載》「英米文学と DH」第20回
「文学と地図」
前回は DH における英文学の分析研究において前提となる遠読と精読の定義を説明した。これまで本連載で取り扱ってきた DH 批評、データの扱いといった、自らの方法論や扱うデータへの問いに留意したうえで、大量のテクストからパターンを見出し可視化する遠読や、あるいは重要と思われる箇所を詳細に調べる精読を、一方を利用したり、時には組み合わせるなどして、分析を行うのが DH のテクストの分析研究となる。自らの手法やモデル、データの扱いを批判しつつ、これまでになかった視点や手法でテクストを解釈する。一歩下がって二歩進むのである。DH の文学研究は、人文学的な批判と絡み合いつつ解釈を求めて進むといえるだろう。
地理的テクスト分析
遠読の研究領域を個別にみていくと、プロット分析、テーマ分析、影響分析、登場人物のネットワーク分析など多岐にわたるが、モレッティは、現在みられる遠読の研究領域の多くについて言及していた。文学形式、文学史、中心から周辺への影響、ジャンル、カノン作品と忘れられた作品、メタデータ、文体、登場人物のネットワーク、文学地図、可視化と樹形図などである[1][2]。これらの領域の中から、今回は文学地図を取り上げたい。地理的テクスト分析、空間文学研究、地理批評、文学地理学などと呼ばれる研究領域である[3][4]。
文学と地図に関わる研究は、基本的には地図に点を打つ行為である[5]。文学テクストや関連資料から、空間や場所に関する用語を抜き出し、該当する地図上の位置に点を打つ。文学テクストで扱われた登場人物の軌跡や作品の舞台が地図上に可視化され、地図として可視化された作品世界をみることで解釈の幅を広げる研究である。
ミハイル・バフチンがクロノトポスの概念として述べたように、時間と空間は文学作品に密接に関わる要素である。それは作品世界を規定し、ジャンルを決定する[6]。数多の騎士がアンジェリカを追いかけて遍歴し、時には対決するアリオストの『狂えるオルランド』の冒頭エピソードは、シャルルマーニュの活躍する時代とヨーロッパ・アフリカからアジアという広大な空間なくしては成立し得ないだろう[7]。クリストファー・マーロウの「恋する羊飼いが恋人に捧げる歌」なども、春のイギリスの田園地方という舞台が、羊飼いが恋人を誘うという作品内容を成立させているといえる[8]。
こうした文学と地図の接点に端を発し、文学作品における地理への興味、もしくは地理学における文学への興味を研究へと昇華させたのが地理テクスト分析ないし一連の地図と文学にかかわる研究領域といえる。モレッティはその意義について、一つの重要な示唆をしている。文学地図は、テクストを分析する準備として、テクストを数個の要素にまとめ、物語の流れから抽象化し、新しく人の手によって作成した応答物を作り上げる。それは部分をすべて足してできた全体以上の何かを含むことになる[9]。通常、物語を読んで読者が頭の中に作り上げる作品世界の地図は、登場人物や場所、時間を端的に配置した心的な関係図である。ところが地図の上に点を打って、地名や登場人物の軌跡を地図化すると、心的な関係としてとらえていたもの以上の解釈が可能になる。
漱石を例としてみてみよう。『三四郎』三の七の路面電車のくだりである[10]。
このテクストを読んだとき、読者の多くは、三四郎は電車に不慣れであるとか、うまく乗れなかったという程度の印象しか受けないだろう。筆者は、飯田橋という知っている地名が出てくるというくらいの印象であった。事実、このくだりは三四郎が野々宮の家に行こうと考えている途中で挟まれた逸話であり、三四郎が都会の人らしく路面電車を乗りこなすことはまだできないことを示す物語の流れの中にある。読者の心的な関係図は、目的地を何度か通り過ごす三四郎と停留所のぼんやりとした位置関係となるだろう。
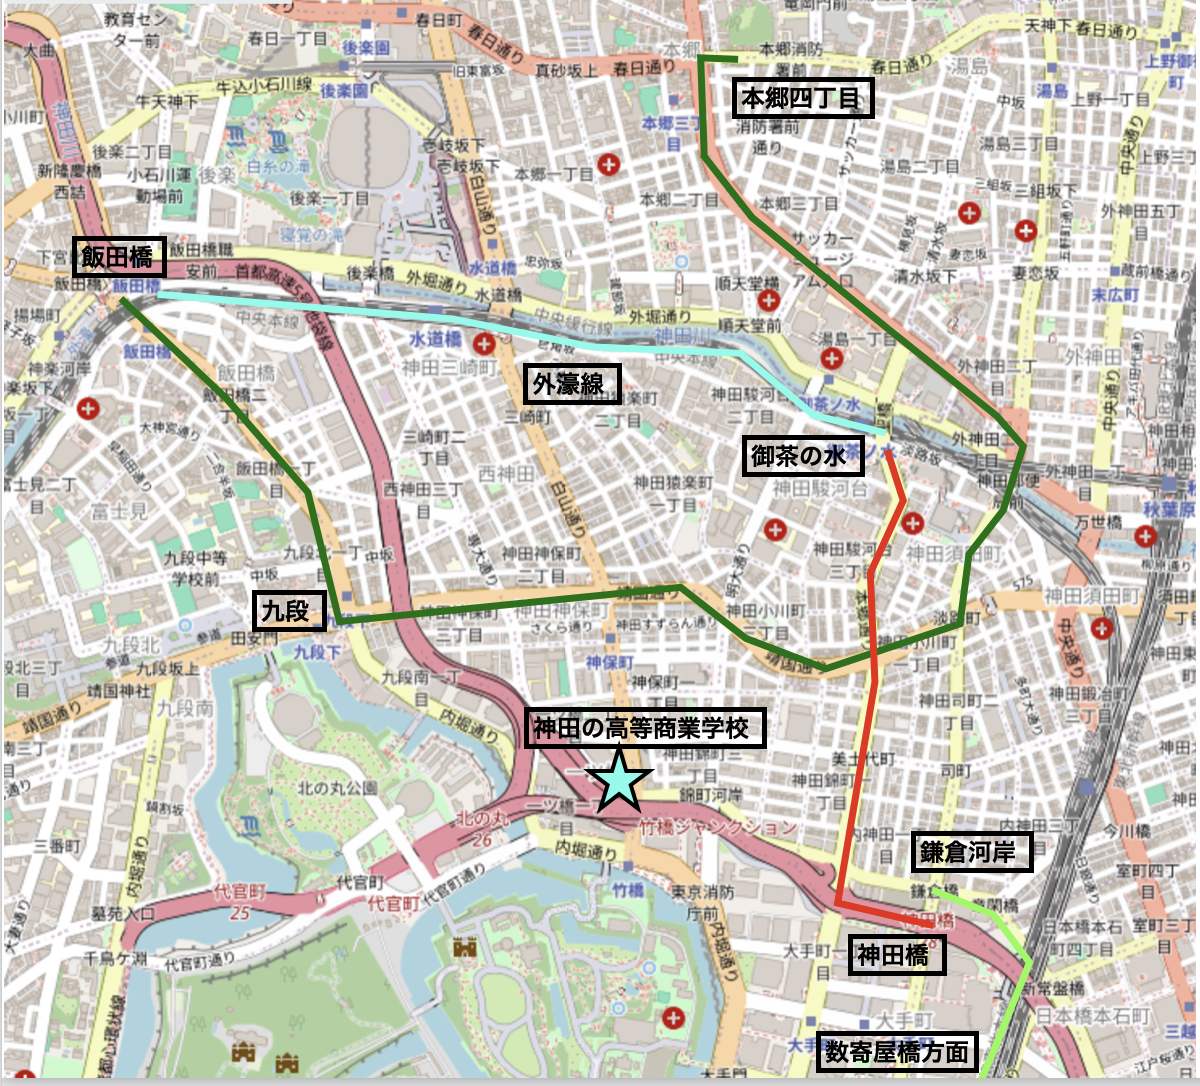
ところがこのくだりを実際に地図に書き起こしてみると、全く異なる解釈があらわれる。図1は、テクストの地名をもとに地図上で点を打った図である[11]。三四郎発表時(明治41年、1908年)の路面電車の駅をたよりに[12]、現代の地図上に三四郎が路面電車、外濠線、その後の歩いてたどった後を示している。出発点は右上の本郷四町目駅、目的地は真ん中より下、水色の星印の神田の高等商業学校である。三四郎は、緑色の路面電車の路線を通り、神田の高等商業学校の最寄り駅を通り過ぎて、九段から左上の飯田橋まで電車に乗る。その後、水色の外濠線に乗り換えて、御茶の水までいき、赤色の路面電車に乗り換えて、神田の高等商業学校の最寄り駅を通り過ぎ、神田橋までいく。ここでおそらく電車を降り、川向うの鎌倉河岸にわたって、黄緑色の道をたどって、数寄屋橋方面、今でいう有楽町駅方面へと歩いてゆく。
地図を見ると分かる通り、三四郎は電車に不慣れというよりは、尋常ではない方向音痴であって、目的地から遠い場所を経巡った後、見当違いの方向に向かって進んでいる。したがって地図上で登場人物の移動の道筋をたどることによって、このくだりは笑いを誘う場面であって、漱石の落語的な逸話のひとつであろうという読み方へと変わる。地理的テクスト分析によって解釈が変わる例である[13]。
地図が文学作品の読み方を変えること以外に、もう一点留意すべき点がある。物語の世界は、必ずしも現実の世界とは限らないということである。ウィリアム・フォークナーの小説舞台を地図化した『デジタル・ヨクナパトーファ』は、架空の小説世界を地図化し、時間軸に合わせて登場人物などの位置を示している[14]。架空の地図が可視化されることで、読みの可能性が広がるであろう。
文学の地図化は、技術的な側面からいえば、自動で地名の固有名詞を抜き出し、地名辞典を利用して地名に緯度経度情報を付与し、地理空間情報データを操作するアプリで地図レイヤに点を打ち、人間の目で修正を施すのが一般的な流れである[3][4]。最近では、人間の判断が必要な箇所を、一般のボランティアが参加可能なかたちで、市民科学の手法を用いて補う試みも生まれつつある。ステファニー・サンチは、文学作品ではないが、文化的構築物としての浮世絵を、正確な位置や角度を特定して時空間情報プラットフォームの地図上に配置するプロジェクトを実施している[15]。文学と地図の今後の発展を垣間見させるプロジェクトである。
今回は、遠読の領域のうち文学地図のテーマを取り上げた。次回はテクストにかかわる遠読の事例を取り上げたい。
人文情報学イベント関連カレンダー
【2026年9月】
-
2026-9-1 (Tue) ~ 2026-9-4 (Fri)
The 36th EAJRS Conference於・Leiden University Libraries -
2026-9-3 (Thu), 8 (Tue), 17 (Thu), 22 (Tue)
TEI 研究会於・オンライン -
2026-9-6 (Sun) ~ 2026-9-7 (Mon)
Code4Lib JAPAN Conference 2026https://wiki.code4lib.jp/wiki/C4ljp2026
於・皇學館大学 -
2026-9-9 (Wed) ~ 2026-9-11 (Fri)
PNC 2026 Annual Conference and Joint Meetingshttps://sites.google.com/view/pnc2026/about-pnc
於・Dharma Drum Institute of Liberal Arts -
2026-9-11 (Fri) ~ 2026-9-13 (Sun)
JADH2026https://www.jadh2026.kyushu-u.ac.jp/home
於・九州大学 -
2026-9-15 (Tue) ~ 2026-9-19 (Sat)
EADH 2026https://eadh2026.confer.uj.edu.pl/en_GB
於・Jagiellonian University -
2026-9-18 (Fri)
第27回 CODH セミナー「歴史ビッグデータの作り方と使い方~データを手作りするプロセスとデジタルツール~」https://codh.rois.ac.jp/seminar/historical-big-data-20260918/
於・国立情報学研究所12階会議室およびオンライン
【2026年10月】
-
2026-10-1 (Thu), 6 (Tue), 15 (Thu), 20 (Tue), 29 (Thu)
TEI 研究会於・オンライン -
2026-10-5 (Mon) ~ 2026-10-6 (Tue)
DiHuCo ワークショップ「人文学研究における AI 協業的環境の設計図〜文献管理からアウトプットまでをシームレスに繋ぐ〜」https://dh.nihu.jp/news/post/20260805
於・東京大学福武ホール
【2026年11月】
-
2026-11-3 (Tue), 12 (Thu), 17 (Tue), 26 (Thu)
TEI 研究会於・オンライン
Digital Humanities Events カレンダー共同編集人
イベントレポート「DH2026」
2026年7月27日から7月31日にかけて、ADHO(Alliance of Digital Humanities Organizations)の第36回年次大会「Digital Humanities 2026」(以下、DH2026)が韓国・大田(テジョン)広域市の大田コンベンションセンターで開催された。「Engagement」をテーマに111のセッションが開かれ、総発表数は493件に及び、参加者はオンラインと対面を合わせて848名以上に上った[1]。
今大会の大きな特徴として、ADHO の年次大会としては初めてリアルタイムの AI 翻訳が導入されたことが挙げられる。各発表はいずれも興味深かったが、筆者にとってはこの翻訳システムが深く印象に残った。そこで、やや変則的なイベントレポートになることは承知しつつ、DH2026における AI 翻訳に焦点を当てた報告を行いたい[2]。
DH2026では、XL8社のEventCAT[3]が翻訳システムとして採用された。翻訳ページはルーム(発表会場)単位で用意され、各会場の壁にはページへのリンクが QR コードとして掲示されていた。AI 翻訳に関する DH2026の公式ページ[4]では英語・韓国語・中国語・日本語の4言語を提供すると案内されていたものの、実際に EventCAT の画面で選択できた言語は、ほとんどのセッションにおいて英語と韓国語のみだった[5]。
大会中に数名の参加者に尋ねたところ、翻訳の質についてはおおむね評価が高かった。筆者自身も、オープニングキーノート[6]で金炫(김현、Kim Hyeon)氏が英語講演中に『論語』学而篇冒頭の「學而時習之 不亦說乎」を韓国漢字音で読み上げた際、AI 翻訳がこの漢文部分を正確に認識し、韓国語字幕には「학이시습지 불역열호」を、英語字幕にはその英訳を表示していたのを見て、その速度と正確さに驚いた。
一方で、翻訳に先立つ音声認識が十分に機能していないと思われる事例もあった。特に、発表者の声が小さかったり、口元がマイクから離れていたりして音声が拾いにくい場合には、音声認識の精度が低下した。ほかの参加者からは、発表内容と無関係な医学用語が字幕に現れたとの報告もあった。詳細は不明だが、これも誤認識に起因した可能性がある。もっとも、音声認識の精度が翻訳の質に大きく影響しうることは主催側も大会開催前から把握していたと思われる。DH2026の公式ページ[4]には、発表者に対する以下のような助言が掲載されている。
実際、発表者の声が十分に大きく、かつマイクを正しく使用していれば、非母語話者による英語もかなり正確に認識され、結果として翻訳も高精度に機能していた。自動音声認識(Automatic Speech Recognition)の進歩を目の当たりにした貴重な体験でもあった。
そのほか、今後さらに改善されるとよいと感じた点についても触れたい。
まず、翻訳システムの利用に難しさがあった。キーノートが行われた大ホールには横長のスクリーンがあり、スライド表示領域の左右に翻訳が表示され、発表を聞きながら比較的容易に訳文を確認できた。しかし、それ以外の一般セッションのルームでは基本的に発表スライドのみがスクリーンに映されていた。そのため、EventCAT の翻訳画面を各自の端末に表示するほかなく、翻訳内容を確認している間は前方のスクリーンに目を向けることが難しかった。特にショートペーパーは発表時間が短いこともあって、手元に目を落としている間にスライドが先へ進んでしまうことも多々あった。
ウェブアプリの機能や操作性にも改善の余地がある。実は後になって気がついたのだが、EventCAT には訳文の読み上げ機能がある。そこで大会後半のセッションでは、片耳にイヤホンを挿し、訳文を耳で確認しながら発表を聞く方式に切り替えてみた。しかし、この方法も十分とは言えず、特に発表者の話す速度が速い場合には訳文の読み上げが追いつかず、発表が進むにつれて読み上げが発表者の発話から大きく遅れてしまう問題が生じた。再生速度を調整できればと思ったが、残念ながら設定を見つけられなかった。
翻訳のラグに関連して、質疑応答での活用にも難しさがあった。英語以外の言語による発表では、質問と回答の往復翻訳に時間を要する様子を確認している。これを避けるためか、質疑応答のみ英語で行われたセッションもあったと聞いた。
こうした点を踏まえると、主催側が EventCAT を活用して優れた翻訳環境を準備・運用していた一方で、その仕組みや活用方法、そして限界については参加者への周知が十分ではなかったと言えるかもしれない。筆者が話を伺った参加者の中には、翻訳システムへのアクセス方法がまったくわからず、大会終盤になって初めてルームの壁に貼られた QR コードの意味を知ったという人もいた。今大会でイベント管理ツールとして採用された Whova[7]の「Agenda」の Overview 欄にもリンクは記載されていたものの、翻訳ページへのアクセス経路はやや分かりにくかったように思う。
会議全体を通して翻訳の質は概して高く、少なくとも筆者には、汎用モデルを無調整で用いただけとは思えなかった。EventCAT の特徴として挙げられている custom glossaries(カスタム用語集)の機能を用い、用語集や発表資料などを事前に登録することでリアルタイム翻訳の精度を高めていたのではないだろうか。そして、総発表数に鑑みれば、こうした準備には相当な労力が注がれたと推察する。多くのセッションで選択可能な言語が英語と韓国語に限られていたのも、翻訳精度を確保するための事前準備のコストが関係していたのかもしれない[8]。
こうしてみると、今大会におけるAI翻訳の取り組みには、人文学的知識を AI が解釈できる形に整えるという、金炫氏が講演で示した「AI に人文学を教える」実践と重なる側面がうかがえる。そして、今大会が AI 翻訳の特性と限界を経験的に学ぶ機会にもなったことまで視野に入れれば、この試みは、AI に人文学を教えることを通じて私たち自身も鍛えるという講演の理念とも響き合うものだったと言えるだろう。
韓国には「시작이 반이다」ということわざがある。直訳すれば「始まりが半分だ」となるが、物事は始めさえすれば半分は成就したも同然だという意味である。DH2026におけるリアルタイムのAI翻訳は、より多様な背景をもつ研究者が Engagement へと踏み出す道を拓く大きな第一歩であった。このような試験的な取り組みに果敢に挑んだ主催の KADH(Korean Association for Digital Humanities)のメンバーに敬意を表し、本レポートを締めくくる。
◆編集後記
今月は、ちょうどお盆の週に、TEI (Text Encoding Initiative) Consortium による年次大会と会員総会がブリティッシュコロンビア大学にて開催されました。カナダのなかでも、ブリティッシュコロンビア州の同大学、ヴィクトリア大学、サイモン・フレイザー大学は、TEI に取り組む研究者が比較的多く、そうした背景から実施されたようです。TEI やテキストデータ構造化に関わる様々な研究発表だけでなく、「The Endings Project」についての発表やワークショップもありました。これは、デジタル・ヒューマニティーズのプロジェクトを持続可能なものにするために、カナダ社会科学・人文科学研究評議会(SSHRC)の研究助成を受けて同州のヴィクトリア大学で開始されました。そして、「デジタル資源の長期持続性のための Endings 原則」を設定し、それを議論しつつアップデートしているようです。現在の「原則」では、以下の5つの項目について、それぞれ、長期持続性を前提とした時にどのような対応をすべきか、ということがまとめられています。
- データ(Data)
- ドキュメンテーション(Documentation)
- 処理(Processing)
- 成果物(Products)
- リリース管理(Release management)
標準的な規格に沿ったデータの作成と、データの意味の説明という基本的な事項をはじめ、様々な必要事項が提示されています。日本でも研究データマネジメントが要請されるようになってきていますが、人文系研究データの場合はどういう風に考えるべきか、という局面でとても有益なものであるように思いました。
巻頭言でも触れられているように、2027年の TEI カンファレンスは、東京で開催されます。みなさま、ふるってご参加いただきますよう、よろしくお願いいたします。
