人文情報学月報第182号
ISSN 2189-1621 / 2011年08月27日創刊
目次
- 《巻頭言》「背いて文学」
:名古屋大学デジタル人文社会科学研究推進センター - 《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第98回
「歴史資料 HTR/OCR において、AI に何を任せ、何を保留させるか―ウィーンで開催された ICDAR/IWCP と SCOOP の参加記」
:筑波大学人文社会系 - 《連載》「英米文学と DH」第21回
「語の頻度:数え上げる」
:中央大学国際情報学部 - 人文情報学イベント関連カレンダー
- イベントレポート「全国大学国語国文学会第133回令和8年度夏季大会シンポジウム「文献学の現在と未来」」
:慶應義塾大学慶應義塾ミュージアム・コモンズ - 編集後記
《巻頭言》「背いて文学」
私はフランス文学の作家論で博士号を取った。博士論文を書くのに、都合十一年かかった。留学期間があったからとか、途中で働きはじめたからとか、もっともらしい理由を話すこともあるが、正直に言えば書けなかったのである。
とはいえ、さぼっていたわけではない。朝から晩まで勉強をして、書いては納得がいかず、積み上げた研究ノートの山を横目に、やはり次の機会にもっと良いものを、と発表を見送ったことは一度でない。ようやく出した論文を自分から取り下げたこともある。研究に実存をかけ、妥協を許さず潔癖で、私は誰よりも文学を愛していると思っていた。
書けないあいだ、私が愛聴していたのは NHK ラジオの古典講読である。『更級日記』や『和泉式部日記』を読む講義を毎週欠かさず聴いていた。放送を聴きながらノートを取り、本文を書き写し、ずいぶん真面目に勉強した。そしてそのたびに、やはり文学はすばらしい、と思っていた。どう考えても博論を書かなければいけなかったのだが、あいにくその頃の私は聞く耳を持ち合わせていない。「博論どんな感じ?」とおそるおそる聞いてくれる人に「うん、書いてるよ」と答えた。もちろん、書けてはいなかったが、そのときには自分が書いていないということすらただしく認識していなかった。ちなみに島内景二先生の講義は本当にすばらしかった。これは本筋には関係ないが、本当にすばらしかったので書いておく。
そんな時期、国立情報学研究所の神田ラボというところで働きはじめた。情報学の新しい問題を作るには人文学の研究者が必要という PI の理念のもと雇用されたのだが、これは博論を書きそびれくすぶっていた私にとって、ほとんど宝くじに当たったようなものである。ラボには数学やアルゴリズムや哲学や歴史学、のちに化学や経営工学といったメンバーが増えていき、朝から終電を逃しそうになるまで、夢中になってさまざまなことを議論した。そこで私が最初に驚いたのは、情報系の研究者が話を聞く姿勢であった。自分の専門とはほとんど関係のない話でも、知らないまま引き下がるのではなく、自分たちの持っている思考の道具でいったん言い換え、理解できる形にしようとする。そして、そこから何かをつかもうとする。最初のうち私は、単に好奇心の強い人たちなのだと思っていた。けれど、長く一緒にいるうちに、それは個人の性格というより、情報系研究者が身につけている思考の習慣なのだと思うようになった。そのうち、私もそのような聞き方と理解の仕方を体得していき、どのような分野の人とでも臆せず話せるという一芸を身につけるにいたった。さまざまな分野の研究者と協働することが楽しくなり、研究プロジェクトを立ち上げては、気ままに話す機会をつくった。何度も徹夜をして夢中でプログラムを書いたり、自然言語処理の読書会をしたりした。分野融合的研究を自然な流れで行うようになっていったのである。
私は、いわば成り行きで分野融合的な研究を始め、幸運にも水が合ったので日々面白がりながら研究をしているが、学会の懇親会や研究会で、ある種の空気が漂っていることも知っている。「あの人は、専門では勝負できないから、ああいうことをやっているのだろう」というものだ。人文学と情報学のあいだで研究をしている私には、この言葉が自分に向けられていると感じる瞬間がある。文学研究の側からは、「テクストを読まなくなった人」、あるいは「良い論文が書けないから計算やデータに向かった人」、情報学の側からは、「本格的な情報学としては新規性がなく、人文学への応用をしている人」と見られる。
私について言えば、やりたいことをやり散らかしていて勝負も何もあったものではなく、こんなに楽しいんだからみんなやりゃいいのにと思っているが、言わんとすることはわかる。一つの専門に深く潜ることにはわかりやすさがある。似た訓練を受け、似た資料を読んだ人による合意のもとで評価がなされるのなら、そこでの力量は比較しやすい。しかし、複数の分野にまたがる研究では、何ができれば十分なのか、その基準自体が見えにくくなる。だから、専門の内部で競うことの方が、研究者の実力をより純粋に示しているように感じられ、専門の中での「勝負」を純粋な勝負だと主張する理由も分からなくはない。
しかし、分野融合的な研究で鍛えられる固有の能力は確かにある。私自身の経験から思いつくものを挙げれば、異なる分野の問いを翻訳すること、一方では自明な前提を他方に向けて言葉にし直すこと、分野ごとに何を証拠とし、何を面白いとみなすか、そのズレをつかむこと、自分の持つ思考ツールを使って未知の分野を理解し、他分野との接触を通じて、自分の専門そのものを相対化すること。そして、そうした作業を重ねるうちに、分野の境界にまだ名前のついていない問いが立ち上がることもある。
これらは、これまで明に光の当たってこなかったタイプの知性であるといってよい。少なくとも、一つの専門の内部にとどまっていたころ、私がこうした力を求められることはなかった。分野をまたいで仕事をするなかで、自然と鍛えられてきたものである。そしてこのあたりの知性の切れ味のようなものが、私が良いと感じる分野融合的研究の中には確かに含まれている。
では、こうした知性の切れ味のようなものを誰がどんな基準で評価するのか、というのは厄介な問題である。一つの専門の内部であれば、何が新しく、何が優れているかについて、ある程度共有された基準がある。けれど、複数の分野をまたいで生まれた研究は、そのどちらの基準にもきれいには収まりきらない。どうすればいいのか、私にはまだよく分からない。ただ、少なくとも私がしなければいけないこと、それは実践を言葉にしていくことであると思っている。分野をまたいで研究するとき、実際に何が起きているのか。何が難しく、どんな力が必要になり、何が面白くて、何に喜びを感じるのか。その手触りを、できるだけ丁寧に言葉にしていくこと。分野を横断的に研究する研究者が何をしているのかが言葉にならなければ、それを評価するための基準も生まれようがない。
冒頭の話に戻る。私はぎりぎりのところで博論を出した。情報学を通り、仲間と議論し、研究することなくして、博論を出すことはできなかった。論文にアルゴリズムは出てこないし、データ分析もしていない。私がずっとやってきた、古典的な方法論に基づいた文学研究の論文である。それではなぜ、私は書けたのか。
因果関係は不明であるが、私が書けるようになったとき、私は自分が楽しいと思える分野融合的な研究ができるようになっていて、カジュアルに博論どうですかと言ってくれる同僚に恵まれ、雇用があった。自分の研究を分野外の研究者に伝える中で自分の思考や説明の仕方が洗練されていく実感があり、自分の専門を相対化できた。
そこから、私は文学研究が楽しくて仕方がなくなった。背いて文学、である。
執筆者プロフィール
《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第98回
「歴史資料 HTR/OCR において、AI に何を任せ、何を保留させるか―ウィーンで開催された ICDAR/IWCP と SCOOP の参加記」
はじめに
2026年9月、ウィーンで ICDAR (International Conference on Document Analysis and Recognition) 2026の併設ワークショップ IWCP (International Workshop on Computational Paleography) 2026と、SCOOP (Source Codes of the Past) の第2回 Exchange Meeting に参加した。文書画像解析・認識の国際会議 ICDAR は8月30日~9月4日に開催され、本会議の一般論文はプログラム上140件、内訳は口頭40件・ポスター100件だった。口頭発表は2会場で並行し、別にジャーナルトラック12件、競技会報告8件も組まれた。本稿では9月4日の IWCP と、9月7・8日に開かれた SCOOP 公開会合を取り上げる。SCOOP には初日に参加した[1]。IWCP では計算古書体学が扱われ、口頭9件とポスター8件、計17件の報告があった[2]。
筆記者識別と専門家の判断
IWCP からは、2つ顕著な発表について紹介したい。まずは、Colin Brisson 氏の「Within the Hands of Amitāyus: Line-Level Self-Supervised Encoders for Intra-Style Scribal Identification」である。同じような書体の写本を行画像から書き手ごとに区別する研究に対し、会場からは、異なる内容の行ではなく、同一文字同士を比較してはどうかと提案された。発表者は、人間の評価には本文の似た行を使ったが、同一文字によるモデルの比較は今後の課題と応じた。
次に、Anguelos Nicolaou 氏ら「TextileNet: Towards Zero-shot Text-style Segmentation of Manuscripts」(P9)は、一頁に何人分の筆跡があるかを調べる試みだった。合成画像で学習した特徴を実資料へ適用すると、記入位置が強い手掛かりとなった。帳簿の本文を書く人と、確認の一行を書き加える人では、位置も内容も異なる。さらに質疑では、同じ人が見出しと本文で書体を変えた場合、それを別人と誤認しないかという指摘が出た。
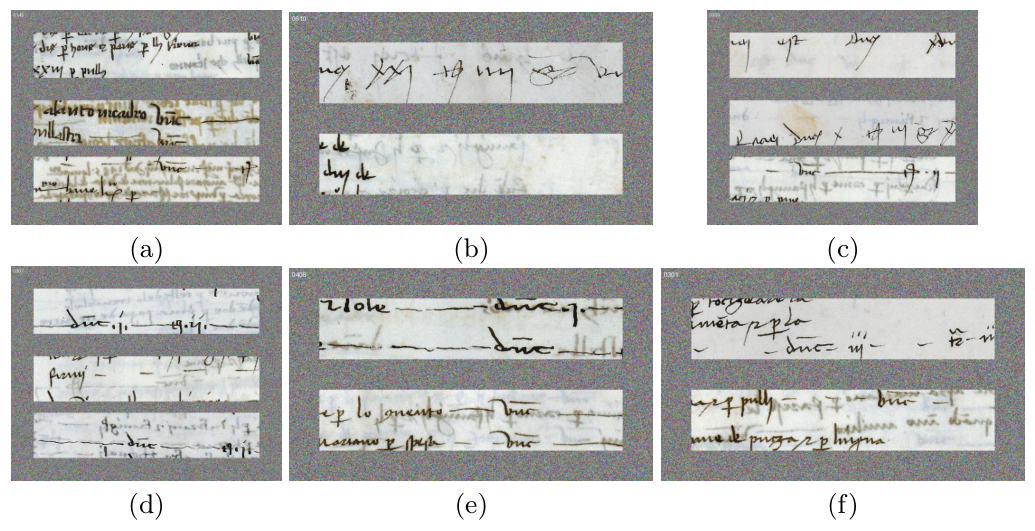
専門家との比較実験をめぐる議論も、この P9の質疑から始まった。評価では画像を見て五~十秒程度で筆跡を判定するよう推奨していた(図1)。これに対し、古書体学の専門知は瞬間的な形の識別に尽きず、本文、文書の性格、年代や来歴を照合する過程にある、との反論が出た。発表者は、訓練された視覚的技能を調べる意図だったと説明した。実験での成績を、専門家の仕事を代替できるという結論に直結させてはならない。
評価指標と「判断保留」
IWCP 総合討論では、評価指標と不確実性が議論された。筆記者ごとの資料数が均等なデータと、一人分だけ豊富で他の書き手は数例しかないデータでは、課題が異なる。一語と一段落でも得られる情報量は違う。そこで、単一の点数に加え、筆記者ごとの資料数の分布と、入力文字量に応じた性能の変化を示す案が出た。
判断を保留する能力の評価も提案された。筆記者を必ずいずれかの集団へ割り当てず、帰属できない標本を特定する。年代も単年を断言せず、根拠に見合った幅を示す。その具体案が、全問への回答を要求せず、たとえば七割の標本をシステム自身に選ばせる評価方式だった。これは討論中の構想である。断定的な回答が有利になる採点方法では、研究者が必要とする慎重な出力が報われにくいという指摘があった。
ただし、指標の改善だけで解決するという合意には至っていない。検索結果から新たな比較や仮説が生まれる価値は点数だけでは捉えられず、人文学者による質的検討と継続的協働が必要だという異論もあった。また、基盤モデルの学習内容が不明なことを踏まえ、所蔵機関が未公開データを保持して評価を提供する案も出た。こちらは未知資料で試せる利点と、外部から結果を検証しにくくなる問題を併せ持つ。
転写と校訂をどう分けるか
SCOOP は歴史資料の自動文字認識を扱う国際ネットワークで、今回はウィーン大学で開催された。6つの作業部会(WG)を軸とする公開2日間のプログラムには一般発表45件、基調講演2件、デモ4件、計51件が掲載されていた。7日は一般28件と基調2件、8日は一般17件とデモ4件である。別にラウンドテーブルなどがあり、9日は内部会合だった。7日午前の一般発表枠は単独だが、同日午後の2枠と8日の3枠は、それぞれ3会場で並行した[4]。
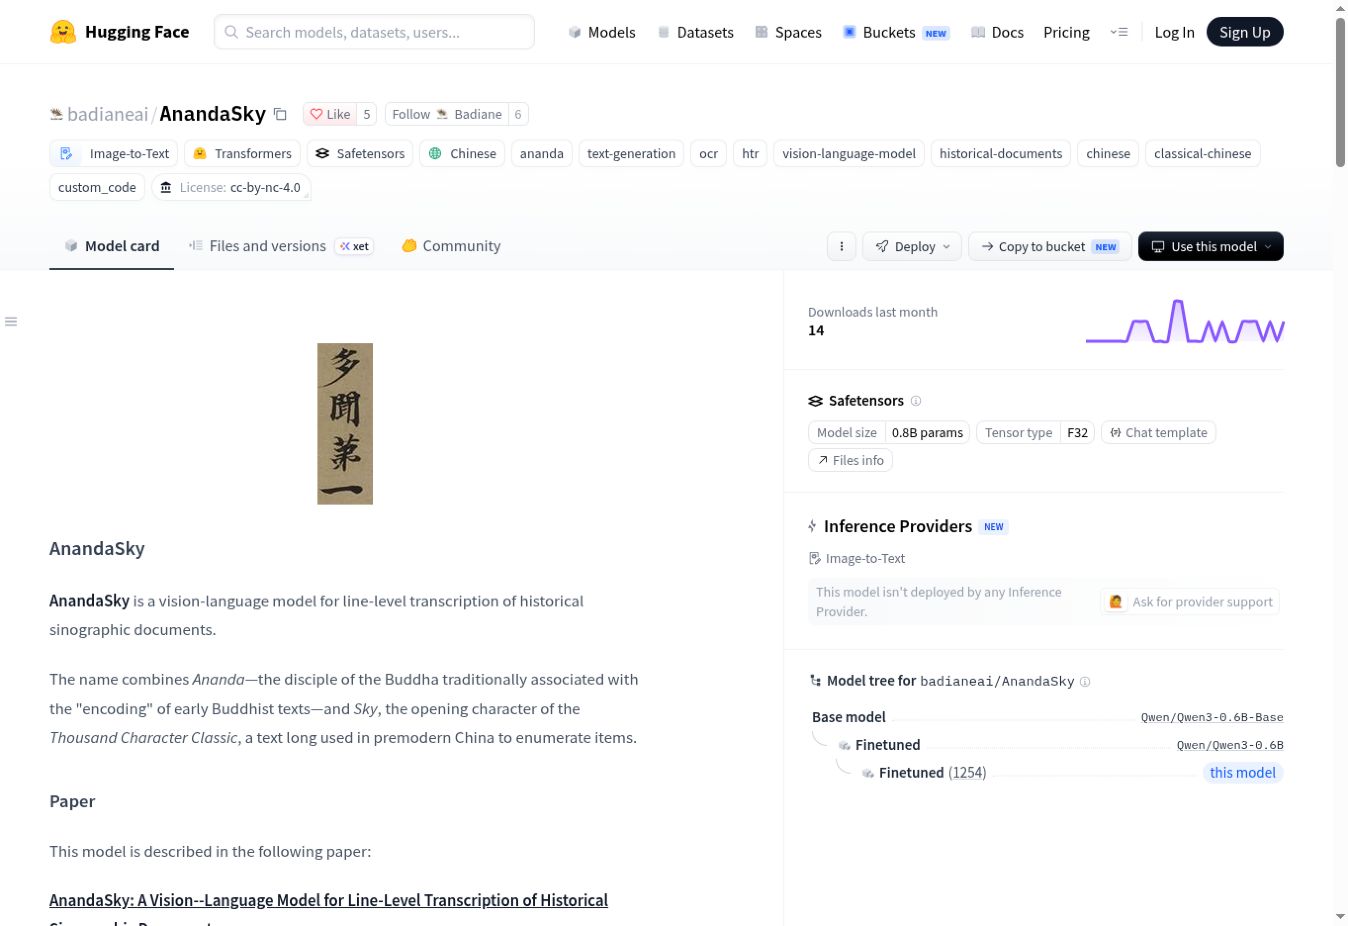
WG1-1「Technologies & Architectures」(Room 1)では、Brisson 氏が漢字資料の行画像を転写する AnandaSky を紹介した(図2)。公開要旨では、認識が高精度になるほど正解データの表記や正規化の違いが評価に影響する点も指摘された。
Thibault Clérice 氏の基調講演「The Transcription/Edition Distinction as a Foundation for Trustworthy Automatic Text Recognition」は、転写と校訂の区別を中心に据えた。画像に見える文字の転写、言語的解釈を伴う正規化、文脈を踏まえた学術的校訂を分ける提案である。略号を展開した本文を正解とすると、画像にない文字を補うモデルが文字誤り率では有利になりうる。何を正解と呼ぶかが、モデルの望ましい振る舞いを先に決めてしまう[6]。
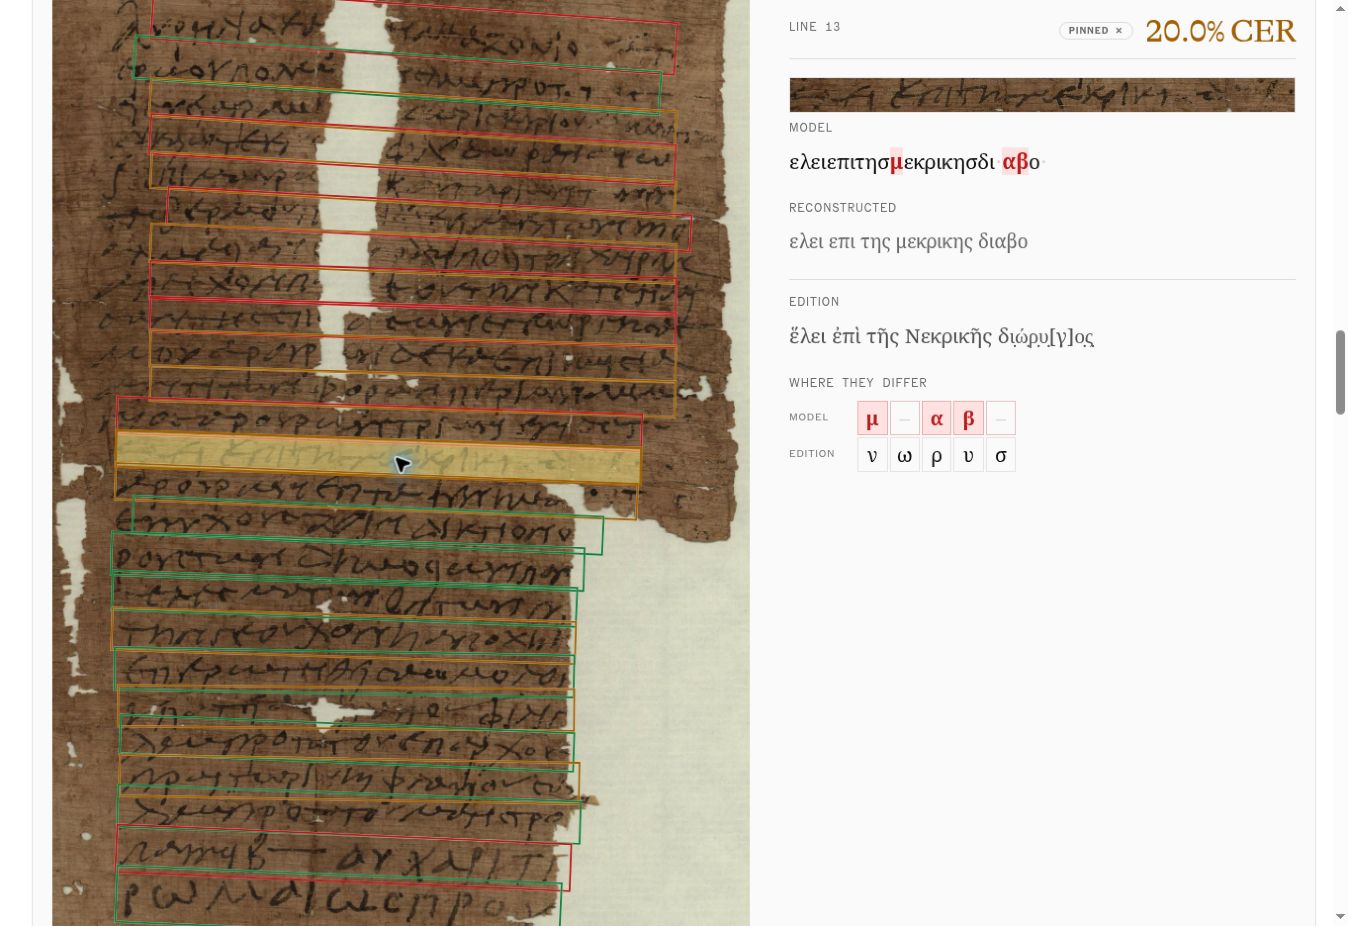
WG1-2では、Elena Chepel 氏と Anton Repushko 氏がギリシア語パピルスの認識システムAnagnostes を報告した。公開実例では行画像と転写を照合でき、見えた文字と校訂上の補いを分ける必要が具体的に分かる(図3)。
WG3-2「Transcription approaches II」では、転写の解釈性が論じられた。Jan Odstrčilík 氏「Otto Dei gram, rogat vram Clam.」(題目略)はラテン語略号を例に、画像に極めて近い転写であっても、解釈を含みうるという問題提起が行われた[8]。同じ枠の Anna Michalcová 氏「Lost in Transcription? Reconciling HTR Output with Old Czech Editorial Standards」は、古チェコ語の綴りでは子音や母音長が一義的に定まらない問題を扱った。解釈済みの本文を学習させれば判断がモデル内部に隠れ、転写後に校訂すれば判断を明示できるが作業は増える。どのような解釈によってモデルがその結果を出力したかが重要なのである[9]。
おわりに
IWCP の筆記者識別・評価と SCOOP の転写・校訂の議論は、AI の出力を研究上の証拠にする条件を問うていた。どこまでが観察で、どこからが推定か。どの条件で判断でき、どこで保留すべきか。専門家が課題と評価の設計に関わり、その区別を後から追跡できるようにすることが、重要になる。
《連載》「英米文学と DH」第21回
「語の頻度:数え上げる」
前回の連載では、文学地図と地図が導く新たな読みについて書いた。文学地図は遠読のひとつの形態であり、テクストを図像的に可視化して文字通り俯瞰することで、テクストに固有のパターンを得て解釈につなげることができる。
今回は単語の頻度に着目した遠読を取り上げたい。計算文学研究や、スタイロメトリーあるいは文体統計学や計量文体学と呼ばれる領域では、テクストにみられる単語の頻度やテクストの外部情報を分析に用いる手法が主流である[1]。文学テクストを分析する際、ジャンルや名声、キャノン、著者推定といった領域や、テクストリユースにおける概念化とモデリング、あるいは文体の変化といった分析視点など、さまざまな領域、範囲で単語の頻度は分析に用いられてきた。
ここでは遠読の最初のわかりやすい例として、数え上げることで文学テクストの分析を行う例を取り上げたい。今回取り上げる例の中には、長い期間の語彙の量の変化をみるという種類の遠読もある。大量のテクストコーパスを用いてある特徴の通時的な変化をみる場合、現在では書誌学的かつ統計的な側面からデータを揃えた上で、理想的には文学批評上の議論から仮説を立て、仮説を検討する上手なモデルを組み立てて当てはめる段階を踏む必要がある[2][3]。もちろん、分析の範囲と扱い方によっては、単語の頻度を数え上げることで適切といえる。今回は遠読を理解する一例として取り上げていると受けとめられたい。
数え上げる
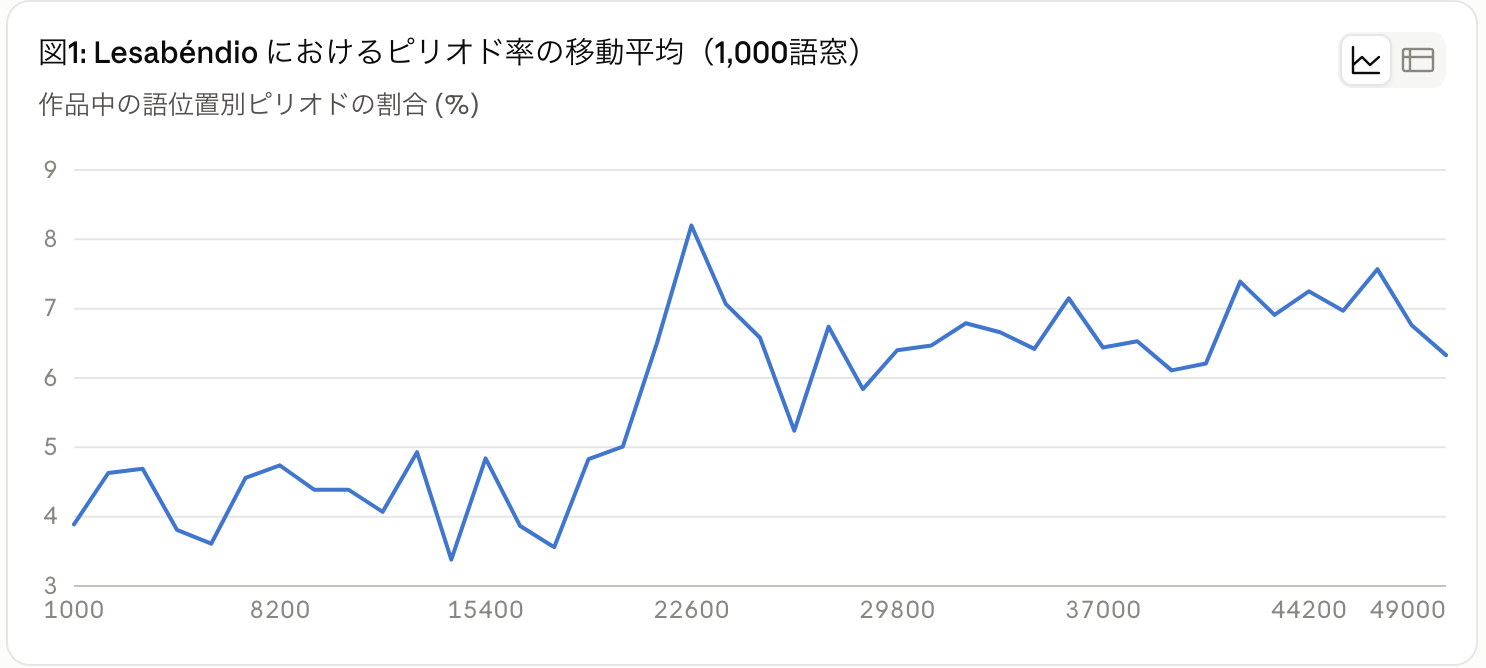
数え上げるという言葉は、アンドリュー・パイパーの研究書の直訳である[4]。パイパーは、文学作品のピリオドの数に着目し、数え上げることで明らかになる傾向を示している。パイパーはピリオドが顕著に意味をなす例としてパウル・シェーアバルトの『小遊星物語』(Lesabéndio)を取り上げる[5]。作品の中でピリオドが使われる頻度の割合を、作品の進行に従って示している(図1参照。コードを元に作成しなおしたもの)。前半と後半でピリオドの頻度が異なり、後半はかなりピリオドの量が多くなる。内容的には、ピリオドが増える箇所は話の転換点であり、主人公と他の主要登場人物の間で確執が生じ、短い台詞が増えるためピリオドが増える。語彙の頻度の変化から、プロットの変化や文章の変化が読み取れる例である。
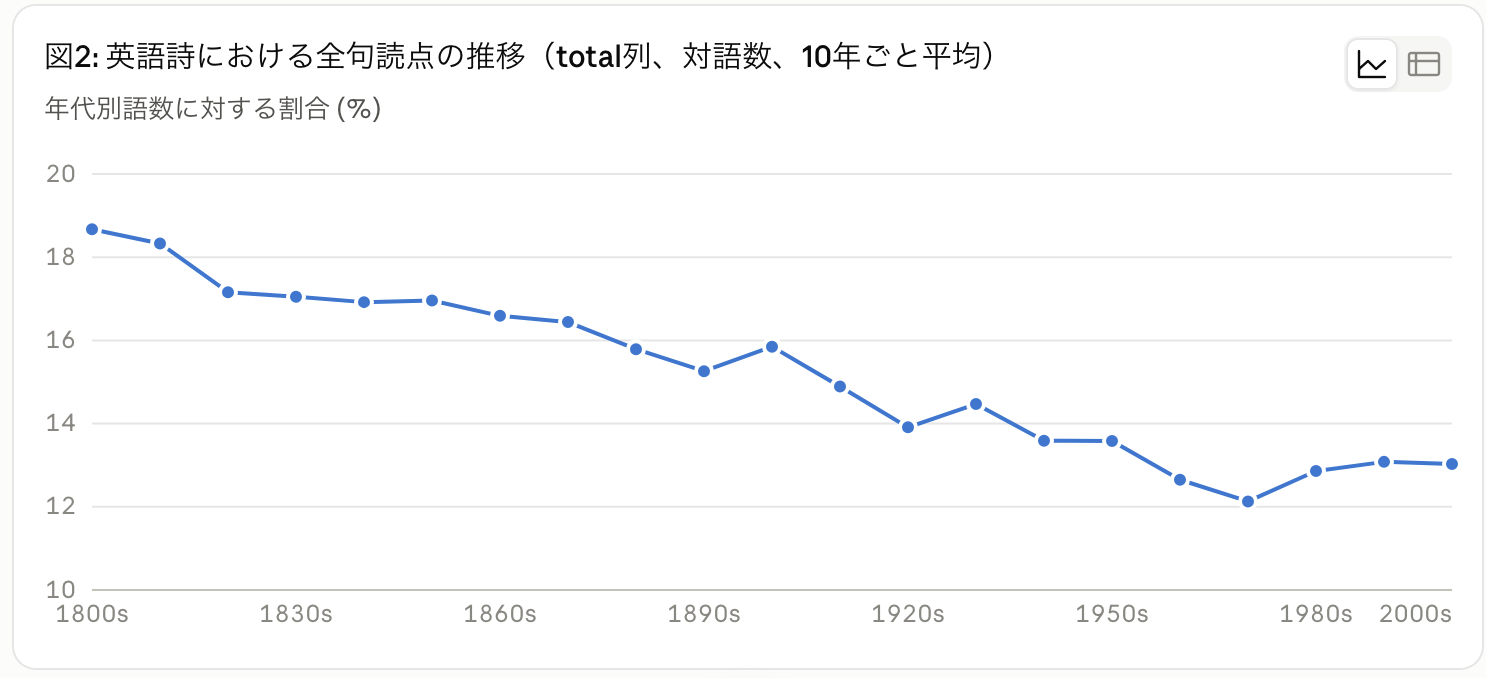
パイパーは同書で、20世紀の英語の詩作品にみられる、ピリオドの過剰な使用もしくはあきらかな使用の回避の関係をみようとした[6]。その際に、通時的な句読点の使用頻度の変化を簡単に示している(図2参照。コードを元に作成しなおしたもの)。現代に近づくにつれ、句読点の使用割合は減っていく。その一方で、精読を踏まえて、ピリオドに、文が閉じることヘの抵抗や開放性といった新しい機能が生じてきたことを示している。ピリオドの意味が変容しているのである。語彙を数え上げることで、遠読を通した新しい見方が生まれ、テクストの読みを豊かにする一例といえる。
ジェフリー・ロックウェルとステファン・シンクレアは、彼らが開発したヴォワイヤン・ツールズ[7]を紹介する過程で、デイヴィッド・ヒュームの『自然宗教に関する対話』の遠読を、単語の頻度に着目して行っている[8]。『自然宗教に関する対話』は、理神論者、懐疑論者、正統的信心家という立場の異なる三人の登場人物が、神の存在と本質について対話を行う書である。ロックウェルとシンクレアは、このうち、懐疑にあたる語彙の頻度を、作品全体、登場人物ごと、あるいは登場人物の作品の進行に応じて可視化している。この遠読は精読に役立てるために用いられる。例えば、理神論者の登場人物クレアンテスは、懐疑論者フィロを無知とみなし第四章終わりでフィロを非難する。この時クレアンテスの懐疑の語彙の頻度が高くなり、懐疑論者フィロの懐疑の語彙はゼロに近くなる。この語彙の不在の意味を、ロックウェルとシンクレアは、攻撃に対する沈黙と読み解いている。このような遠読の分析方法も、語彙を数え上げることで読解に繋げる例である。
最後に、マシュー・ジョッカーズの例を取り上げたい[9]。ジョッカーズは、アメリカ英語とイギリス英語の言葉の違いを可視化しようとした。特に定冠詞theを取り上げて、イギリス小説とアメリカ小説における定冠詞の用法の違いを、語彙の頻度の違いに移し替えて、1800年から1900年の間の定冠詞 the の相対頻度をグラフ化した。ジョッカーズが作成したグラフから読み取れることは、アメリカ英語の方が1%ほど定冠詞 the の使用が多く、またイギリス小説およびアメリカ小説双方の定冠詞 the の使用頻度の変動は密接に相関しているということだった[10]。ジョッカーズは別の語彙の頻度の変動と比較し、定冠詞 the と他の語句は頻度の変動が異なることを導き、定冠詞theがイギリス英語とアメリカ英語の違いを表す指標の一つである可能性を示している。
以上、今回は、数え上げるということをテーマに、語彙の頻度にもとづく簡易な遠読の例を見た。語彙の頻度は遠読分析の基本ともいえるが、簡単に数え上げるだけでもさまざまなことが理解できることが察せられたことと思う。次回も、語彙の頻度の続きを行いたい。
人文情報学イベント関連カレンダー
【2026年10月】
-
2026-10-1 (Thu), 6 (Tue), 15 (Thu), 20 (Tue), 29 (Thu)
TEI 研究会於・オンライン -
2026-10-5 (Mon) ~ 2026-10-6 (Tue)
DiHuCo ワークショップ「人文学研究における AI 協業的環境の設計図〜文献管理からアウトプットまでをシームレスに繋ぐ〜」https://dh.nihu.jp/news/post/20260805
於・東京大学福武ホール
【2026年11月】
-
2026-11-3 (Tue), 12 (Thu), 17 (Tue), 26 (Thu)
TEI 研究会於・オンライン -
2026-11-16 (Mon) ~ 2026-11-20 (Fri)
ICOM-DOCUMENTATION 2026https://icomdocumentation2026.africamuseum.be/
於・AfricaMuseum (Tervuren, Belgium)
【2026年12月】
-
2026-12-1 (Tue), 10 (Thu), 15 (Tue), 24 (Thu), 29 (Tue)
TEI 研究会於・オンライン -
2026-12-2 (Wed) ~ 2026-12-4 (Fri)
ICADL 2026: The 28th International Conference on Asia-Pacific Digital Librarieshttps://easychair.org/cfp/icadl2026
於・Khon Kaen University(Khonkaen, Thailand) -
2026-12-12 (Sat) ~ 2026-12-13 (Sun)
人文科学とコンピュータシンポジウム「じんもんこん2026」https://jinmoncom.jp/sympo2026/index.html
於・京都大学吉田キャンパス
Digital Humanities Events カレンダー共同編集人
イベントレポート「全国大学国語国文学会第133回令和8年度夏季大会シンポジウム「文献学の現在と未来」」
2026年6月13日(土)午後、日本大学文理学部キャンパスにおいて、全国大学国語国文学会夏季大会が開催された。「文献学の現在と未来」というテーマが掲げられたように、国文学研究、特に資料調査・本文研究と DH との関わりに焦点を当て、現在の研究の到達点を振り返るとともに、未来を見据えた議論がなされた。
シンポジウム前半は、資料画像を中心としたデジタル化による調査・研究の発展について、特に原本調査とデジタル閲覧との関係性を中心に、中古文学から近代文学の各専門領域のパネリスト4名から報告があった。後半は、コメンテーター2名から、前半の各報告を踏まえた見解と、人文学領域とデジタル技術との関わりと今後の可能性、課題について言及がなされた。最後に会場・オンライン参加者からの質疑応答と、登壇者による共同討議が行われた。
国文学の各学会では、近年、DH をテーマに掲げたシンポジウムが積極的に行われている。稿者は、これらのシンポジウムを複数拝聴したが、今までの議論によって最も自覚的になった事柄として、教員・学生・機関・出版社など立場を問わず、研究に携わる上では、デジタルデータの利用者であり、同時に作成・公開者にもなり得るという点である。利用と作成・公開は常に循環し続けるものであり、両側面からの議論が必要だが、本レポートでは議題を整理するために、各パネリストの報告順ではなく、利用、作成・公開を中心とした内容の順に紹介する。なお、本レポート執筆にあたっては、各パネリスト・コメンテーターの資料を参考にした。
まず、デジタル画像の利活用における可能性と課題を提示したのは、松永瑠成氏と大貫俊彦氏である。松永氏は「中本研究における封切紙という視座」と題して、近世版本の小本・中本の洒落本、滑稽本や人情本に見られる「封切紙」という現代の袋とじのような機能を持っていた紙の残存状況と痕跡の調査から、デジタル画像を用いた研究に対する見解を述べた。松永氏によれば、封切紙は、貸本屋を通した書籍の流通や受容が制作にも影響を与えた例として重要だというが、僅かな紙片しか残っていない場合、デジタル画像上では封切紙だと判別することは難しいという。だが、原本調査の経験や知見があり、封切紙の特徴を知っていることで判別できる可能性があることを具体的な画像を用いて説明した。大貫氏は「デジタル研究環境がもたらす可視性/不可視性―近現代資料の調査の観点から―」と題し、まず「古川ロッパ日記」では、資料の翻刻出版の過程で削除・編集された本文に対して、デジタル化によって原資料へのアクセスが可能になり、全文の閲覧をはじめ、年月日での確認、原本上欄の発信・受信情報から書簡の検索ができるようになったことを述べた。反対に、真山青果の研究手帳では、資料の糊付けや削除箇所、インク移りなどがデジタル画像では視認できず存在しないものになることを述べ、デジタル画像を用いた調査がもたらす二側面を明らかにした。両氏はともに、実地調査とデジタル上での閲覧がいかに補完しうるかという点、更に、封切紙では原本に触れた経験、青果の研究手帳では覗いたり透かす動作により判読できるという、デジタル技術の進展だけでは解決できない点を指摘した。
久保木秀夫氏は「開かれた/拓いていく本文研究」として、デジタル環境がひらく調査の可能性と、デジタル画像のみでは明らかにできない、アナログな調査によって分かることを、古典籍・古筆切の原本調査の経験に即して報告した。稿者が特に印象に残ったのは、デジタル公開されている資料画像で撮影漏れのあるページが見つかったという例である。撮影・公開に際して、人による作業である以上ミスを完全に防ぐことは難しく、デジタル環境が整いつつある現代でも直接資料に触れて調査することの大切さが示された。また、以前「古筆切所収情報データベース」(現在は、国文学研究資料館学術情報リポジトリ https://kokubunken.repo.nii.ac.jp/records/4704 に掲載)の作成・公開を行ったこと、現在は『和漢朗詠集』の TEI 準拠テキストデータを試作しているという報告があった。久保木氏は、データの作成者側として、紙幅の制限なく、IIIF 準拠のデジタル画像と対応させつつ校異情報も示せるという、TEI の利点についても言及していた。
同じく TEI を用いた事例として、盛田帝子氏は「ホノルル美術館所蔵『十番虫合絵巻』のデジタル公開について」という題で、『十番虫合絵巻』に関する共同研究の成果を、書籍とともにウェブサイト(十番虫合絵巻 https://juban-mushi-awase.dhii.jp/)で公開したことを紹介した。ウェブサイトは、テキストデータや作品の構造、現代語訳・英訳を記述し、IIIF 準拠画像も参照させた TEI 準拠のテキストデータを「虫合絵巻ビューワ」で分かりやすく表示することを目指したものである。2024年の公開後に盛田氏が大学の講義などで活用した所感も述べられ、オープンアクセスによって門戸が開かれる一方、原本や作品への基礎知識の有無によって教育効果に差が出るという報告があった。
各パネリストの発表からは、資料への深い知識や調査の経験を培った上で、デジタル画像の特性を理解して適切に用いることの重要性が浮き彫りになった。後半の共同討議でも、久保木氏からは、データベースのアクセス制限や、デジタル画像が容易に閲覧できることで、原本やマイクロフィルムが参照されにくくなるという問題、大貫氏からは個人情報を含む可能性のある資料画像を公開する場合の倫理性の問題が挙げられた。またテーマからはやや逸れるが、盛田氏からは、翻訳では和歌とその場で鳴く虫の音の優劣を競う虫合の当座性や風情の再現が難しいという課題が述べられた。このように、デジタル環境を含めて、資料と資料に関するあらゆる情報を原本の「モノ」から他の形式に置き換える過程では、失われる情報があったり、権利等の問題が生じる可能性があることを理解しておくべきだろう。
更に稿者は、当日の議論を踏まえ、今後は機関や資料の所蔵館のみならず、研究に携わる各々が、研究成果やその基礎データをデジタル上に掲載するという方向にも目を向ける必要があると考えている。コメンテーターの岡田圭介氏が指摘したように、昨今 DH では、AI、広く言えば機械可読性の高いデータをどのように整えるかという視点での議論が進んでいる。同じくコメンテーターの幾浦裕之氏からは、HumanitextAozora(https://aozora.humanitext.ai/ja)やバウッダ AI(https://agni.dhii.jp/bd-rag/)、みんなで翻刻 OCR(https://yuta1984.github.io/honkoku-ocr-web/)など、AI 技術を用いた研究支援システムの事例が紹介されたが、このようなシステムを構築するには大量のデータが必要になる。人文学領域では、資料画像公開の整備と OCR 技術によるテキスト化は進んでいるものの、特に国文学分野では、現在でも、研究的知見に基づく作品テキストの提供や成果公開は、雑誌論文や紙の書籍の出版という形でなされていることが多い。更に、その過程で作成された基礎データも、ほとんどは個人の手元に留まっている[1]。だが現状のままでは、オープンな形式での再検証や利活用ができず、デジタル上での蓄積や継承、機械的処理も困難である。こうした中で、盛田氏や久保木氏の報告にあった TEI は、国際規格に準拠した機械可読性の高いデータ形式でテキストを作成することができ、専門的知見も付与することができる。TEI に準拠したテキストデータの構造化は、国文学分野でも既に複数の作品で試みられており、今後は取り組みの周知と参画者の拡大が必要である。益々デジタルへと移行する研究環境においては、画像データだけではなく、作品本文や研究成果など、テキスト領域のデジタル基盤構築に向けた検討も重要である。
共同討議の最後には、複写物やデジタル画像が公開されていても、原本調査が必要な理由を研究者自身が説明し、積極的に閲覧しようとする姿勢が大切であるという意見でまとまった。デジタル環境と原本資料、書籍による成果公開等など、調査方法や公開の媒体は二項対立するものではなく、相互補完できるものである。デジタル化は、国文学分野に興味を持つ人を増やすとともに、研究の公平性の確保という面でも重要であり、ひいては研究分野と対象資料の継承や保存にも繋がる。こうした議論が一過性で終わることなく、技術の進展や社会情勢と呼応しつつ継続的に行われ、デジタルデータの利用と作成・公開の在り方に対して、研究に携わる様々な立場の人が主体的に考えていくことが大切である。
◆編集後記
9月10日に、日本学術会議から、見解「人文学・社会科学におけるオープンサイエンスを踏まえた質的研究のためのデータ基盤の形成」(https://www.scj.go.jp/ja/info/kohyo/pdf2/kohyo-26-k260910.pdf)が公表されました。地域研究委員会・言語・文学委員会・哲学委員会・心理学・教育学委員会・社会学委員会・史学委員会・法学委員会・経営学委員会・情報学委員会という、様々な分野の委員会が合同で設置した「デジタル時代における新しい人文・社会科学に関する分科会」によるものです。日本学術会議でも、DH に正面からコミットするスタンスが認められるようになってきたようで、ほっとしているところです。
また、今月は、名古屋大学の日比嘉高先生と加藤弓枝が世話人となって、日本文学とデジタル人文学研究会(https://jlitdhgroup.wixsite.com/jlitdh)が発足したそうです。筆者も早速登録をさせていただきましたが、今後が楽しみですね。
また、早稲田大学では、10月の10日と17日に、DH関連のイベントが開催されるとのことです。徐々に各地で DH への動きが深まっていっているようです。
デジタル媒体・デジタル技術の特徴にきちんと対応する形で人文学のワークフローを組み立てなおすという流れは、今後ますます必要になっていくことが想定されます。本メールマガジンからもそれに役立つような情報提供を続けていければと思っております。今後ともよろしくお願いいたします。
