人文情報学月報第183号
ISSN 2189-1621 / 2011年08月27日創刊
目次
- 《巻頭言》「自然言語で地図を作る:QGIS MCP が変えるもの、変えないもの」
:筑波大学人文社会系 - 《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第99回
「古代エジプト・ヒエログリフ入力の歴史と Unicode」
:筑波大学人文社会系 - 《連載》「英米文学と DH」第22回
「語の頻度:遠く見るもの」
:中央大学国際情報学部 - 人文情報学イベント関連カレンダー
- 編集後記
- 「デジタル研究基盤としての令和大蔵経の編纂―次世代人文学の研究基盤構築モデルの提示」ニューズレター第7号(本誌「特別付録」として隔月配信)
《巻頭言》「自然言語で地図を作る:QGIS MCP が変えるもの、変えないもの」
私は2026年4月から筑波大学で歴史地理学の教員として勤めている。専門は移動の歴史地理であり、近現代日本を対象にしたさまざまな移動(人口移動、海外移民、観光、ツーリズムなど)をテーマに研究を行ってきた。昨今の地理学分野では、隣接諸分野と同様に AI の発展が大きな影響をもたらしている。たとえば GeoAI(地理空間人工知能)とよばれる新たな研究領域の登場など、その影響は枚挙にいとまがない。そのなかで私は最近、生成 AI エージェントに自然言語で GIS(地理情報システム)を操作させることに多くの時間を注いでいる。地理学者の共通言語は地図だとよくいわれるが、話し言葉で地図づくりができるようになれば、地図に苦手意識を持つ人にも、地図を作り、地図で考えるきっかけが生まれるのではないか。そう思って、この技術を使い倒してみている。
私が専門とする地理学において、地図を作る方法は大きく2つに分かれる。1つは、Adobe Illustrator や Inkscape のようなドローソフトを用いて作る方法で、こだわって美しい地図を作りたいときに向く。もう1つは ArcGIS や QGIS のような GIS ソフトウェアで作る方法で、手早く手堅い地図を作るのに向くが、データがなければ何も描けない。過去の地理を復元しようとする歴史地理学の場合、そもそも GIS 上で使えるデータが存在しないことが多い。だから多くの歴史地理学者は、古地図をドローソフトでトレースして地図を作ってきたし、私自身、実は大学院に入るまでは GIS にほとんど触れたことがなかった。
それでもやはり GIS は使ってみると便利である。歴史地理学においても、史料批判と研究者どうしの議論を経た地理情報データが整備されれば、研究の幅は大きく広がるだろう。ROIS-CCFSS 人文学オープンデータ共同利用センターが進める「地図・地誌類領域」のデータ整備は、まさしくそのようなニーズに応えるものといえる。こうした動きに応えるために、私も現在、これまであまり取り組まれてこなかった歴史的な人口移動に関するデータ整備に取り組み始めている。まだ道半ばの状態ではあるが、どうにか形にしたいと考えている。
こうしたなかで私が最近気になっているのが、生成 AI エージェントとソフトウェアをつなぐ MCP(Model Context Protocol)の技術である[1]。MCP とは Claude で知られる Anthropic 社が公開した技術である。私なりには、MCP は AI を各種ソフトウェアに接続して、自然言語によって指示が出せるようにする仕組みとして理解している(もちろん専門家からみれば異なる説明があると思う)。AI から自然言語で指示が出せるようになれば、複雑な操作手順を習得しなくてもツールが動くのだから、機械に弱い人にとってはとてもありがたい技術である。とはいえ、2026年2月末には「MCP is dead. Long live the CLI」というタイトルのブログ記事が話題となり[2]、MCP 技術は早くも時代遅れの技術としてみられることもあるようだ。しかし、地図作成に関していえば話は別だと私は思う。画像生成 AI で作った地図は正確性に欠けると指摘されているように[3]、生成 AI が地図や空間を「描く」こと自体はいまだ苦手である。だからこそ、AI 自身が地図を描くのではなく、AI が GIS を動かして地図を作る仕組みこそが、地理学者にとっては大きな意味を持つ。
私がこの記事を書いている2026年10月現在、GIS と AI エージェントをつなぐ MCP のうち最も実用に耐えるのは、QGIS と接続する QGIS MCP であると考える。QGIS MCP は GitHub で公開されており、プラグインとして誰でも簡単に導入できる[4]。私も使ってみてみたが、地図作成と空間分析の手間が大きく変わったと感じる。自然言語で指示すれば、AI がデータを取得して QGIS に読み込み、投影し、印刷レイアウトまで表示してくれる。データを PDF に書き出せば、ドローソフトで仕上げることもできる。主題図の作成にかける時間は、体感では半分以下になった。出力された地図に iPad で赤を入れ、そのデータをもう一度 AI に投げれば、ふたたび QGIS MCP が動作して修正版が返ってくる。この往復を繰り返すことで、それなりの地図はできる。いまでは地図の多くを QGIS MCP で作るようになった。なんとも素晴らしい技術である。
しかし、QGIS MCP を使用して気づいたことがある。それは、MCP によって自然言語による直感的な地図作成が可能となったとはいえ、地図作成の技術と知識が人間の側になければ、意味のある地図は作れるようにはならない、ということである。出力された地図をみて、投影法、階級分類、出典表記等が妥当かどうかを判断するのは人間の側である。地理学や歴史地理学の論文では、研究内容はもとより掲載する地図の完成度や品質が求められる場合が多い。そこで間違った地図を出してはいけないし、作図の際にも必要な情報を取捨選択しながら描かなければならない。だから、GIS の操作は AI ができるようになっても、出力された地図の検証はどうしても人間が判断する部分なのである。出てきた地図のどこが間違っているかを見抜く検証能力は、むしろこれまで以上に求められるであろう。
もう1つ気づいたことがある。ドローソフトで地図を作る際に、私はどちらかといえば「見た目」や「直感」を頼りに地図を作成していた。他の論文に描かれている美しい地図をどう再現するか、という美的感覚を重んじてきたのである。これに対して GIS は空間分析を主眼とするソフトウェアであるため、データをいかに機能的に配置して分析し描画するかに重きが置かれている。そのため、これまでも GIS で出力した地図を論文に掲載する場合、ドローソフトを使って美しい地図になるように修正を施してきた。それでは、QGIS MCP を介して地図を作れば美しい地図になるかというと、決してそうではないことも多い。凡例が間違っていたり、ラベルが重なったまま平然と出力されたりと、人間なら犯さないようなミスに出くわすことがある。どれほど指示を重ねてプロンプトを改良しても、この美的感覚だけはすぐには身につかないらしい。
こうした違和感は、地図を作ることに対する共同体的な規範や文化の影響が大いに関係していると思われる。日本の地理学では、これまでも地図表現について多くの作法が培われてきたし、ドローソフトによる主題図作成の技法も教科書レベルで継承されている[5]。地理学者にとって地図を作ることは単なる作業ではない。どの情報を採用し、何を省き、どう空間を表現するかという1つ1つの判断が、研究にとって重要な意味を持つ。地図は、そこに描かれたものだけで成り立っているわけではない。何が史料として残り、何が選ばれ、何が地図に描かれなかったのかを把握し、その空白の意味を読むことも歴史地理学者の仕事であろう。AI によって地図を作る技術が変わろうとしている今だからこそ、地図を通じて何を知ることができるのかを、改めて問い直してみたい。地図を作る操作を AI に委ねられるようになったとき、人間に残るのは何を判断することなのだろうか。
執筆者プロフィール
《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第99回
「古代エジプト・ヒエログリフ入力の歴史と Unicode」
はじめに
ヒエログリフをコンピュータで入力するには、文字を選ぶだけでは足りない。文字は上下左右に組み合わされ、まとまりのある区画に配置される。この配置をどう再現し、検索・再利用できるデータとして残すか。本稿では、WinGlyph、JSesh、VisualGlyph、EZGlyph/ProGlyph、Keyman、旧 SINUHE と、筆者が新たに作成した SINUHE HieroTyper Unicode を比較する。
符号から組版へ
初期の電子化を支えたのが、1988年に刊行された Manuel de Codage(MdC)である。MdC は特定のソフト名ではなく、ヒエログリフの文字と配置を英数字・記号で記述する方式を指す。Gardiner の文字目録では、A1は座った男性、O1は家の平面図を描いた文字である。音価から指定できる文字もあり、「nfr」は F35に対応する一文字を呼び出す。語の綴り全体を自動生成したり、文章を翻訳したりする機能ではない[1]。
配置には「:」で上下、「*」で左右の結合を指定する。「A1:O1」は A1の下にO1を置き、「A1*O1」は両者を横に並べる。「(A1*B1):O1」なら、A1と B1を横に並べた組の下にO1を置く。括弧でまとまりを指定することで、二次元の配置を一次元の文字列に記述できる。MdC と Unicode は別の符号化方式であり、相互の変換には文字と配置指定の対応付けが必要になる。
1990年代に普及した WinGlyph は、この方式を Windows 上で利用する代表的な専用ソフトだった。1993年の版は Hans van den Berg の名で記録されている。研究者は符号列を編集し、整形したヒエログリフを論文へ組み込めるようになった。ただし、完成した図を貼り付けるだけでは、貼付先で個々の文字を検索できない。再編集には元の符号データも必要になる[2]。
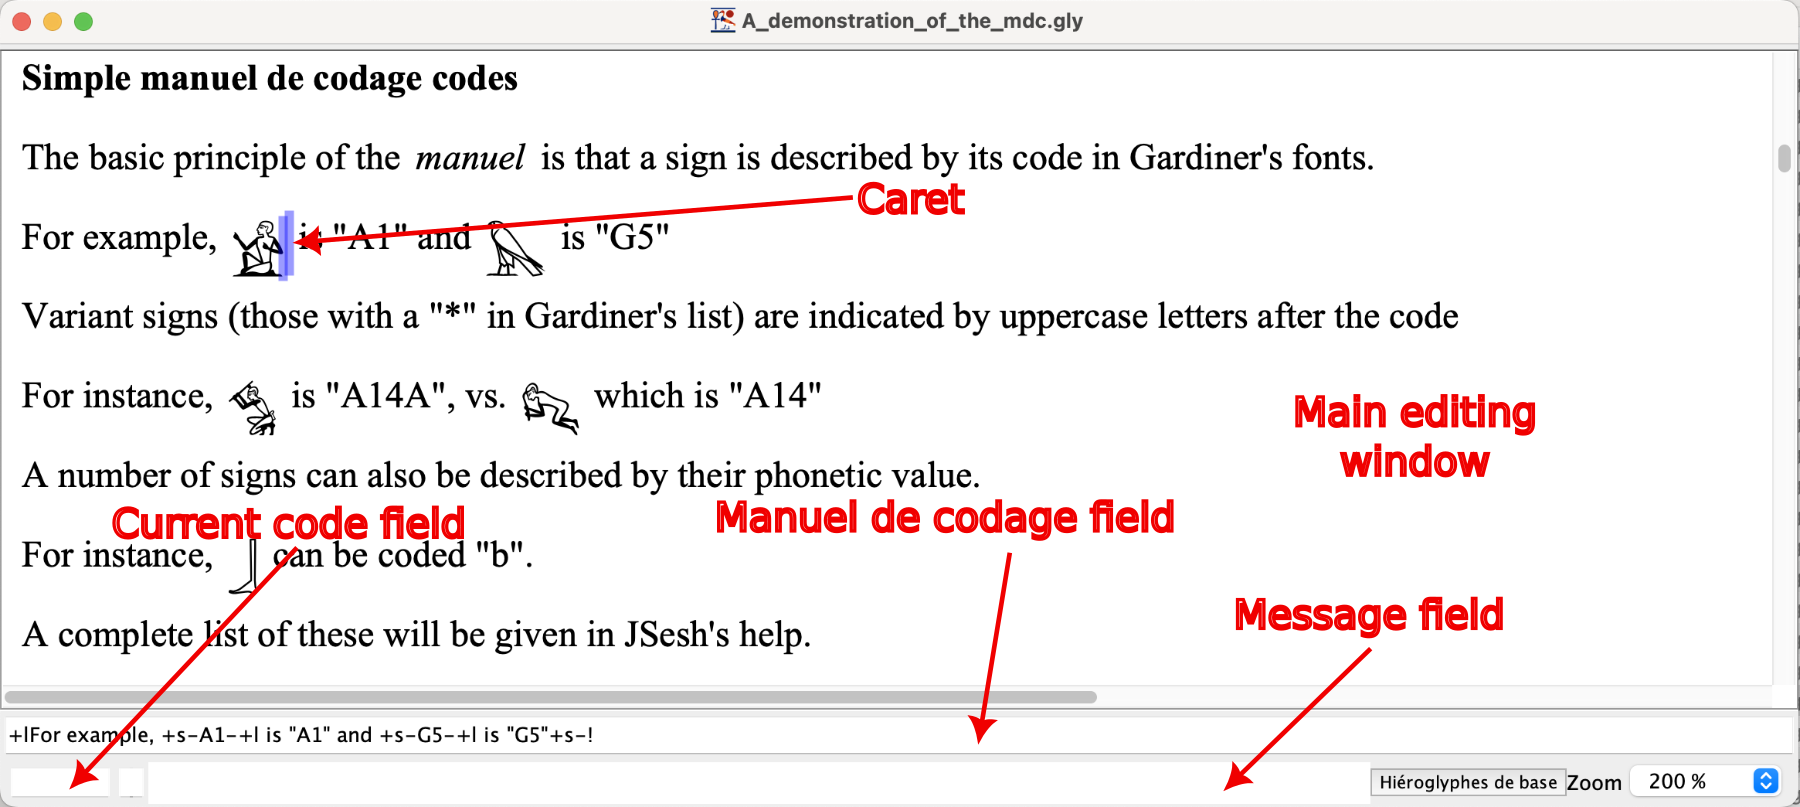
2000年代から開発が続く Serge Rosmorduc の JSesh は、無償で利用できるソフトウェアで、MdC を基盤とし、WinGlyph のファイルも読み込める。専用画面で文字群や欠損表示を編集し、独自の字形も追加できる(図1)。PDF や画像への出力を備え、文献学的な組版に適した環境である[3]。
配置の自由を重視する方法
バーゼル大学が紹介する VisualGlyph は、複数の伝本を並べる対照版の作成を重視する。文字の位置、大きさ、回転、反転を個別に調整でき、通常の文章や線も同じ紙面に置ける。一方、入力時の翻字列は変換後に保存されない。自由な紙面設計が、そのまま検索用の本文データを保証するわけではない[5]。
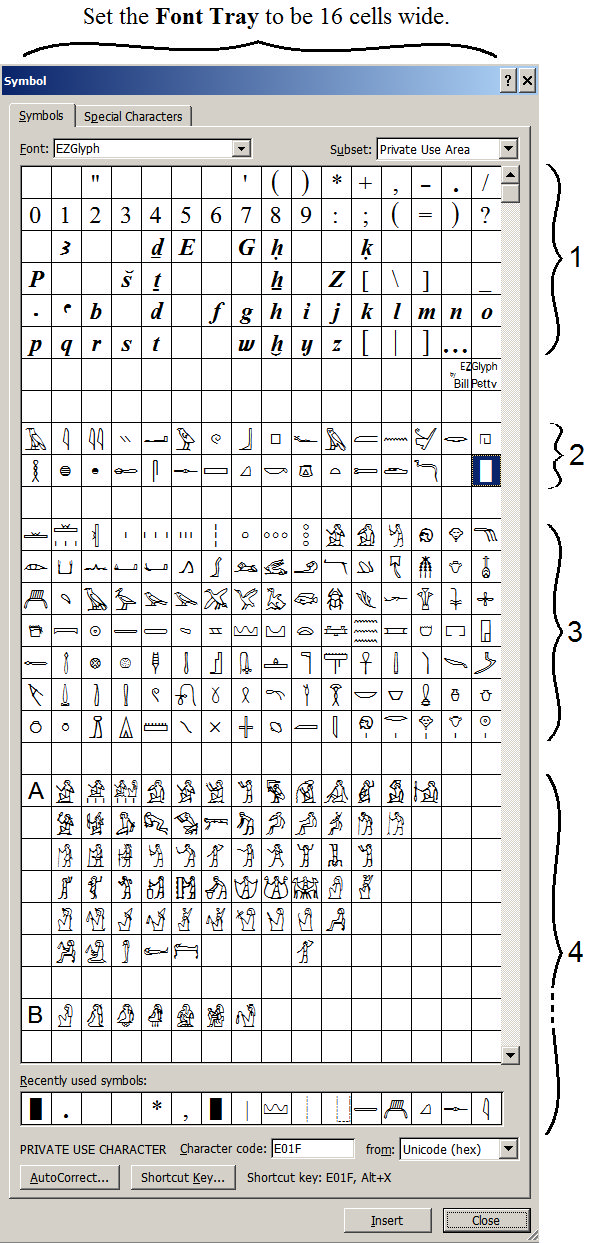
Bill Petty の方法は、EZGlyph というフォント群と ProGlyph という Word 用マクロ群である。Word の太字・斜体などの指定を、文字の上下配置や重ね合わせに利用する。ProGlyph は MdC 変換にも対応し、Word 内で本文とヒエログリフを編集できる(図2)。ただし、配置は専用フォントと書式の組み合わせに依存する。書式を除いて文字だけを取り出した場合にも、同じ配置が残るとは限らない[6]。
Unicode と直接入力
2009年の Unicode 5.2は、ヒエログリフの基本的な文字集合を収録した。Unicode は、異なる環境で文字を識別するための共通規格である。これにより、対応する環境ではヒエログリフを通常の文字としてコピーし、検索する基盤が整った。しかし、文字の符号化だけで、上下配置や文字の重なりまで解決したわけではない[8]。
Keyman Desktop は、多言語の入力方式を実行するための基盤である。ヒエログリフには、Christian Casey による Hieroglyphic キーボードを区別して挙げる必要がある。MdC 式の翻字や Gardiner 番号を入力し、スペースキーで Unicode 文字へ変換する。同じ音価を持つ文字は、スペースキーを繰り返して切り替えられる[9]。
通常のアプリに直接入力できるが、入力方式そのものに紙面の組版機能があるわけではない。表示は入力先のアプリとフォントに依存する。
日本語入力の技術を使う SINUHE
筆者は2015年のライプツィヒでの研究会で、日本語入力の技術をヒエログリフへ応用する方法を発表し、2016年に論考を公表した。HieroJIS は Google 日本語入力を利用し、読みから候補を選ぶ操作を応用している。文字を一つずつ探すだけでなく、語の翻字から、音声補助符や限定符を含む綴りを呼び出せる[10]。
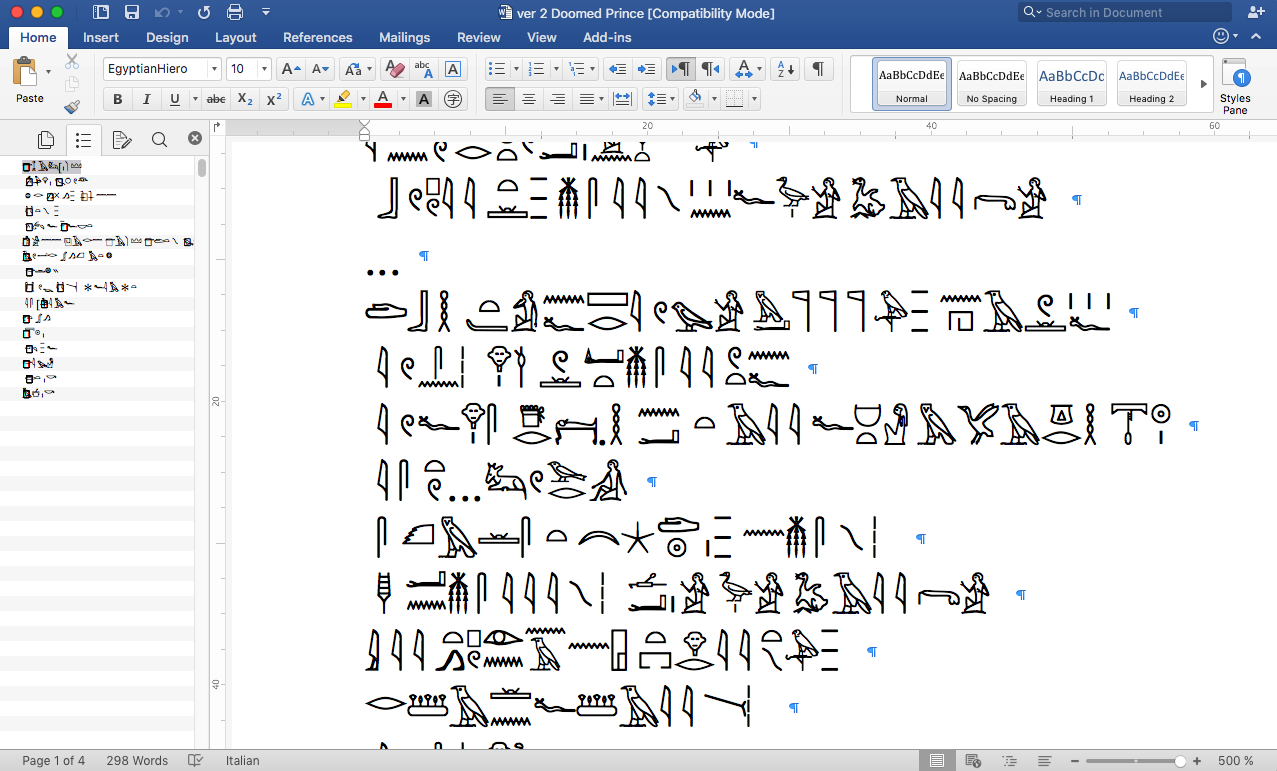
この入力方式と Marwan Kilani のフォントを組み合わせたのが、SINUHE the Hierotyper である。語の翻字、音価、Gardiner 番号、対象のカテゴリーから入力でき(図3)、フォントの合字機能によって基本的な組み合わせを表示する[11]。
SINUHE は語単位の変換候補も利用する点に特徴がある。ただし、候補の綴りが史料の綴りと一致するとは限らず、転写では音声補助符や限定符を確認する必要がある。また、初期 SINUHE の合字表示と、後の Unicode 規格による配置指定は、同一の仕組みではない。
文字の共有から配置の共有へ
2019年の Unicode 12.0では、ヒエログリフの組版制御文字が導入された。上下・左右の結合や挿入などを、文字列の中で指定する仕組みである。2022年の15.0では制御文字が拡充され、2024年の16.0では3,995文字が追加された。同時に、文字の出典や機能などを扱う Unikemet も導入され、文字集合と関連情報の整備が進んだ[13]。
SINUHE HieroTyper Unicode の試み
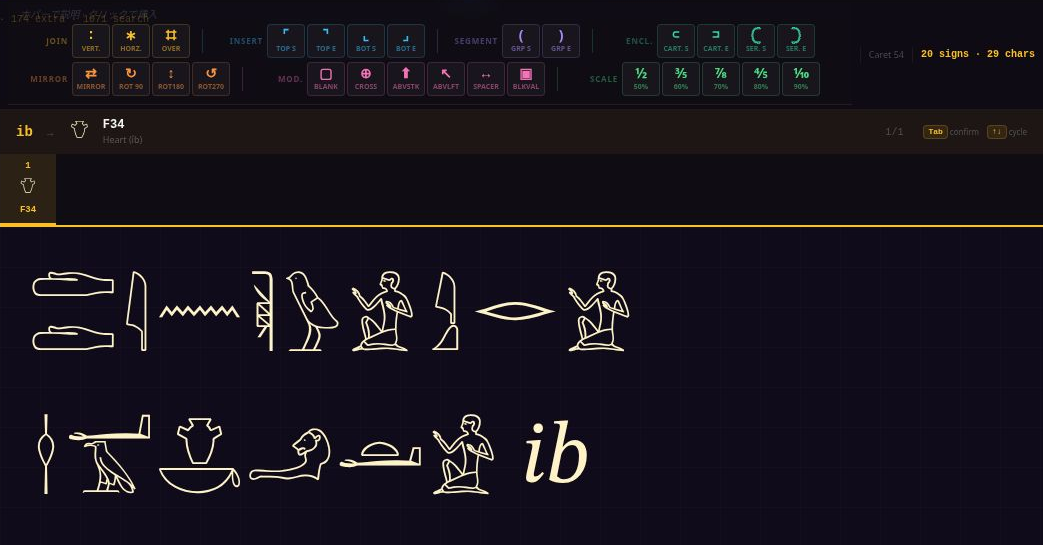
新しい SINUHE HieroTyper Unicode は、ブラウザ上で文字の選択と組版を行う入力環境である。公開画面では1,071文字を検索対象とし、音価、Gardiner 番号、カテゴリーなどから文字を探せる。文字パレットに加え、上下・左右の結合、重ね合わせ、挿入などの操作を備える。旧 SINUHE が日本語入力の仕組みを応用したのに対し、新版はウェブ上に編集画面を用意する[14]。
新 SINUHE のメインの入力モードである日本語のローマ字入力風入力モード(図4)では、旧 SINUHE と同様、ヒエログリフの発音や、文字番号、または象っているモノのカテゴリー(「男」なら「MAN」など)を入力することで、ラテン文字子音転写をヒエログリフ Unicode に変換できる。さらに、Unicode 制御文字を上のボタンから挿入することで、縦置きや中置きなど文字同士の様々なレイアウトが可能になった。
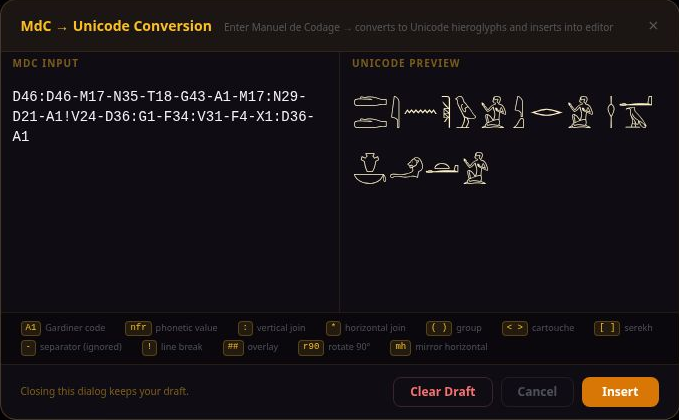
さらに、MdC から Unicode への変換も行える。MDC ボタンで入力欄を開き、MdC を入力すると、上下配置、左右配置など様々な配置を制御文字で可能にした Unicode 文に変換される(図5)。
おわりに
各方式は目的に応じて選ぶ必要がある。細かな組版には JSesh、自由配置や対照版には VisualGlyph、Word 内での編集には EZGlyph/ProGlyph が適している。Keyman と旧 SINUHE は通常のアプリへの直接入力を、新しい SINUHE HieroTyper Unicode はブラウザ上での入力・編集を提供する。
人文情報学にとって問われるのは、見た目を再現した結果と、検証・再利用できる本文をどう結び付けるかである。原資料の画像、編集用データ、Unicode へ変換した文字列を対応付け、変換で失われた情報を記録する。研究上の判断を追跡できるよう、保存の対象を広げる必要がある。
《連載》「英米文学と DH」第22回
「語の頻度:遠く見るもの」
前回に続き、語の頻度にもとづく遠読の例を今回も探りたい。前回は簡単な遠読の例として、単語の数を数え上げることでみえてくる文体的傾向や登場人物の心の動きの推測などをとりあげた。今回は、文学テクストの遠読の中でも長い期間の語彙の量の変化をみるということに焦点を当てたい。主にテッド・アンダーウッド『遠い地平(Distant Horizon)』第一章に依拠している[1]。前回と同じくテクスト中の単語の数を数えることのみをとりあげているが、大きな枠組みの中で分析結果を位置づけることは思いのほか難しい。基礎的な事項を知るという意味で、今回はアンダーウッドの研究書の解題の形式をとっている。
長期の時間軸にみる語彙の量の変化
本連載のタイトルにつけた遠く見るものとは、古代イランのある文献で使われた言葉である。祭司や詩人が、空間や時間を超えて世界を知覚するといった超自然的な能力を求めたときに用いたのであろう [2]。そのように、遠読も数世紀単位の年月や距離の離れた国々に通底するパターンや要素を見通す分析に使われることがある。
目安を知るといった簡易な種類の遠読と異なり、長期の時間軸で文学テクストを分析する場合、文学研究内の確立した領域をまたぐ本格的な分析となることから、研究上のさまざまな留意点に気をつけながら進める必要が出てくる。この点については最後に触れたい。
英文学の小説批評においては、語る技法と示す技法の二分法が議論されてきた。特に、ヘンリー・ジェイムズの『大使たち』「序文」(1903年)にはじまる、出来事を直接語ることで伝えるよりも、視覚的な状況を提示して間接的に示す方が優れた技法であると唱える見方は議論を巻き起こした[3][4][5]。この批評の延長線上に、ライアン・ヒーザーとロン・ル・カクは色彩や身体表現などの語彙が19世紀を通じて増加することを計量的に示し、19世紀の小説において語ることから示すことへの移行が起きたと述べた[6]。
語ることから示すことへの移行は本当にあったのだろうか。19世紀の期間だけを調べ、身体表現に使われる語句だけを数えることで、小説全般にかかわる大きなトレンドの推移を示しえたといえるのだろうか。アンダーウッドは、ヒーザーとル・カクのこの分析を1700年から1922年に期間を拡大し、ひとまず色彩に関する語彙をとりあげて、それらが数世紀を通じて増加することを示した(図1)[7]。
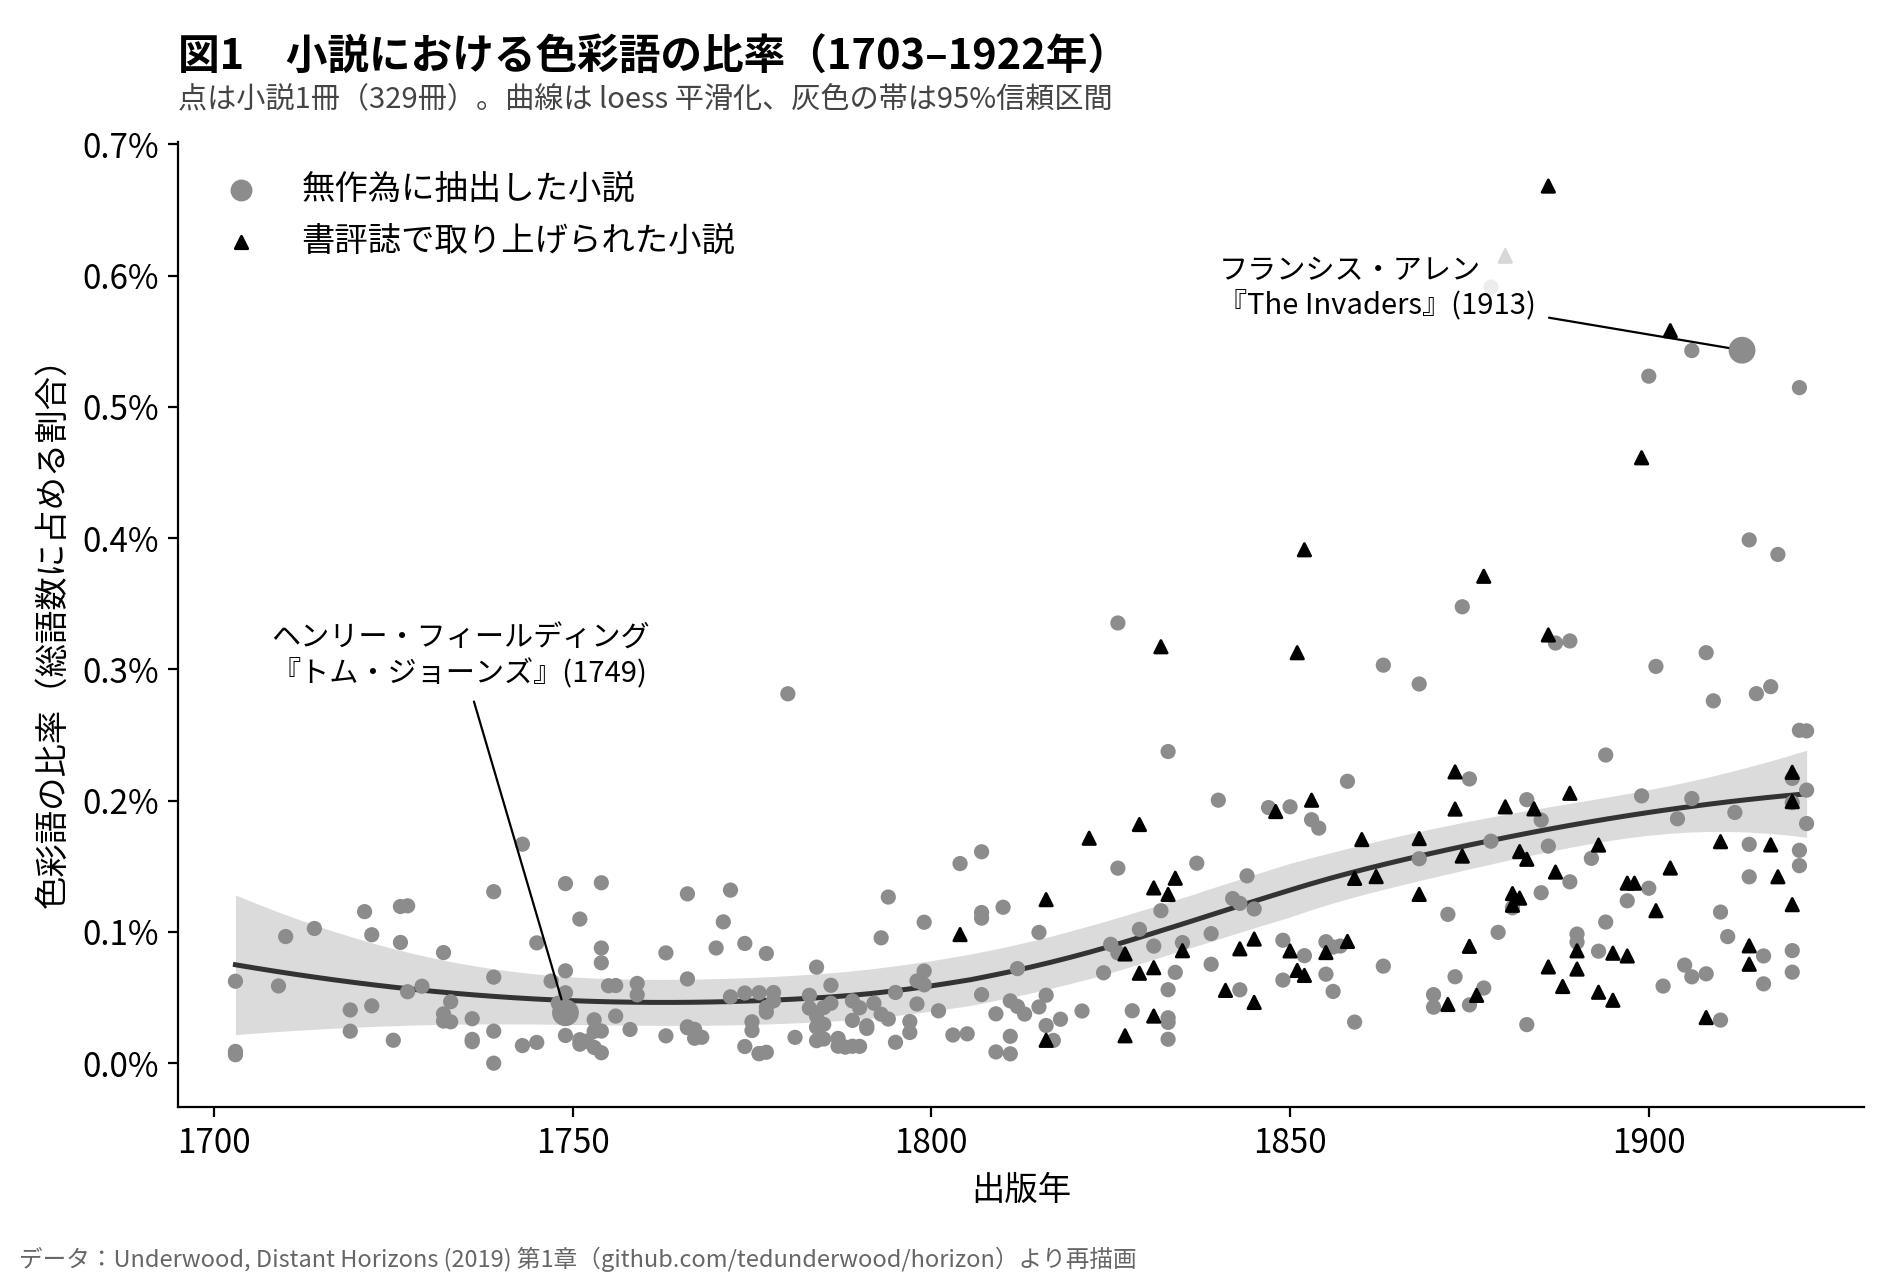
図1は、アンダーウッドが、ハティトラスト・デジタルライブラリから抽出された329冊の書籍について、51語の色彩に関する語彙の相対頻度(一冊の書籍の総語数に対する色彩語句の総数。色彩語句の出現割合)を各書籍ごとに計算した図である。この図からわかることは、色彩の語句については220年間の分析期間内で増加していることである。この期間に何が起き、なぜ色彩の語句が増加したのかはこの図からだけではわからない。このデータだけをもって、語ることから示すことへ移行があったというには、性急である。少なくとも、身体表現にかかわる語彙が、2世紀にわたって、小説のジャンルで増加することをみる必要がある。
そこでアンダーウッドは、相関する他のトレンドを調べた[8]。1700年から1999年にわたる小説1935巻と伝記1829巻をそれぞれのジャンルで年ごとにまとめ、動作知覚動詞、身体部位、色彩語、位置や方向を表す前置詞や副詞、数詞、物理的性質を表す形容詞といった身体的描写を表す際に使われる語句506語の出現回数を、総語数で割った割合を出した(図2)。示すことが増加したかどうかを知るために、色彩語に加え、同じく描写表現で主に用いられる身体表現にかかわる語彙が使われる様子を計算したのである。加えて、小説以外のジャンルも追加することで、示すことの語句の増加が英語全般にかかわる変容であるのか、小説のみのトレンドであるのかを調べた。その結果、小説における語句は19世紀後半以降増加したのに対し、伝記における語句は横ばいであったことがわかった。
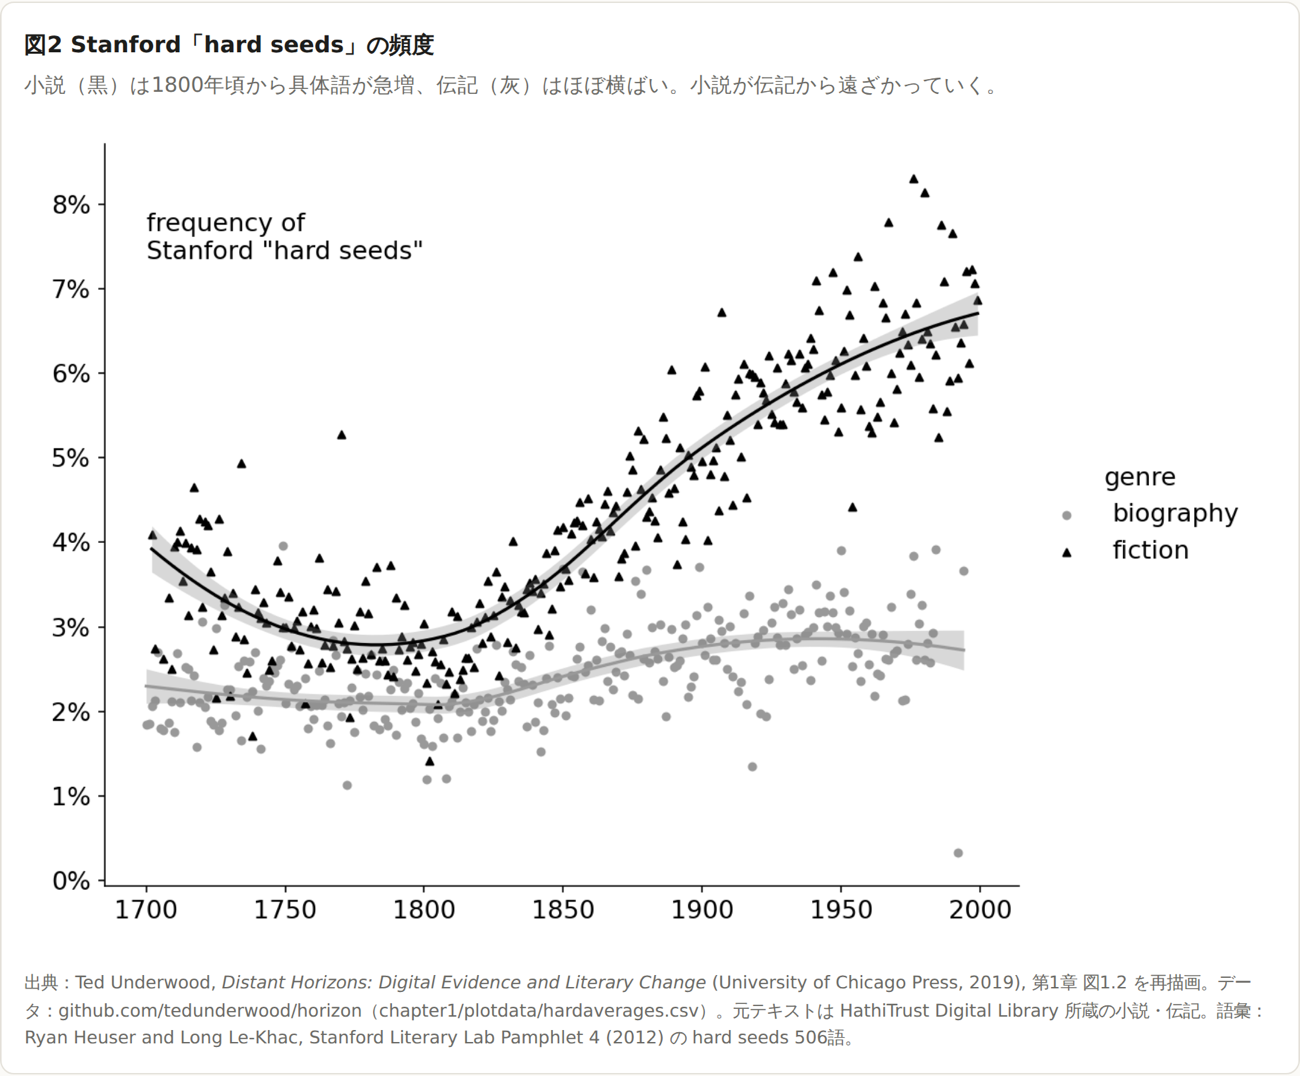
図2からわかることは、身体的描写を表すときに使われる語彙は、小説では増え伝記では増えなかったことであり、それは小説以外の全てのジャンルにも通じる英語の広範な変容ではないということである。小説では身体的描写を表す語彙が増えたということは、語ることから示すことへの移行があったといってよいのだろうか。アンダーウッドは、このトレンドを、「直接的な体験の描写への移行」と述べている[9]。図1と図2からわかることは、色彩語が増えたということ、色彩語を含む身体表現にかかわる語句が小説で増え、伝記で増えなかったということのみであり、それらの組み合わせが示す範囲は、小説において直接的な体験の描写が増えたというところまでである。語ることから示すことへの移行という広範な現象ではない。
このように、アンダーウッドは、長期の時間軸における大規模な分析においては、ひとつの現象だけから長期の時間軸に渡る広範な文化現象の原因を推測することはできないことを説いている。語ることから示すことへの移行というのは、さまざまな要因が絡み、因果関係が複雑に入り組む現象である。大規模な分析を行う際、複数の相関する他のトレンドを調べ、比較することが必要だが、単に数を数えるだけでは足りない。そこでは、文学的に意味がある分析、すなわち文学批評と接続した問題意識を、統計モデルを用いた定量的分析によって読み解く必要があるとアンダーウッドは説いている[10]。
この後、統計モデルを用いたフィクションと伝記が異なる確率や、小説内で表される時間の感覚の推移といった他の分析をあわせて、アンダーウッドは、小説が具体的な描写に向かって推移していく様を示す[11]。統計を用いた遠読については次回以降述べたい。いずれにせよ、アンダーウッドの主張は、長い時間軸にわたる変化の曲線を明らかにできることが遠読の強みであるという点にある[12]。
文学現象は非常に複雑であり、大規模な分析を行おうとするほど、複雑さが増していく。ある文学現象を構成する要素は無数にあると考えられるのに対し、大量のデータやテクストから一定のパターンや特徴を選び示す遠読[13]の分析が示しうることは、ひとつか数個の要素にすぎない。すくなくとも、複数の異なる視点から遠読の分析を行い、それらをあわせて考える必要がある。
大規模な遠読を行う際の留意点
最後に、長期にわたる大規模な遠読を行う際に注意する点に触れておく。アンダーウッドはさまざまな留意点に触れているが、4つほどとりあげたい。それらは、文学的意味を持たない現象を追求してデータの結果だけ出しても意味がないという“so what?”(だから何)問題[14]、人間の感情や考えは数値に還元できないという立場からくる批判[15]、文学研究は少数の詳細なテクストから推測を行う探索的な研究である場合が多いという問題[16]、そしてすでに知っていることを繰り返し調べており意味がないという批判[17]の4点である。どれもこれまでにこの連載でとりあげてきた、DH 批評でよく取りざたされる批判である。
最初の2点は研究デザインおよび研究手法の段階で対応が必要である。データの結果だけを出しても意味がないという“so what?”問題については、既存の学術上の議論に接続し、時には解釈上の仮説から初めて仮説を検証する方法をとる必要がある[18]。文学批評や文学研究でとりあげられている議論と関連づける必要があるということである。また還元主義への批判に対しては、相関する他のトレンドを探し求め、異なる視点を考慮して比較を行い、不確実性へ対応する方法を用いる必要がある。ひとつの分析結果をより大きな構造の中に位置づけた一事象ととらえることも大切である[19]。
またアンダーウッドによれば文学研究は詳細なテクストからはじめて既存の価値を逆転させる読みをよしとする傾向があるが、それは学問的伝統に結びついたひとつの方法にすぎない[20]。それ以外にもさまざまな方法がひらけているのである。
最後に、既存の知見を再度分析しているだけであるという批判は、アンダーウッドによれば、長期の時間軸にわたる遠読の分析にはあてはまらない。文学研究は通常、限定された時代と場所の中で発達するため、各時代と場所で既知の現象が、時代や場所を超えてもあてはまるかどうかは別の問題である。したがって、時代を超えて長期の時間軸で既知の文学現象が確認されることには大きな意味があると主張する[21]。
以上、今回は、長期の時間軸にわたる大規模な遠読を行う事例と留意点についてアンダーウッドの事例を用いて述べた。デジタル人文学研究において、分析研究はますます重要になっている。その一方で、規模が大きくなるほど文学現象の複雑さが増し、伝統的な人文学研究のみを行なってきた研究者が参入するにはハードルが高くなってきていると思われる。今回は、社会科学的な手法とあわせて実行する遠読の代表的な分析を解説することで、大局的な方向性と細かな個々の分析を常に考えあわせること、結果からわかることはここまでであるという範囲とこれ以上はわからないという範囲、そして実行にあたって気をつけるべきいくつかの点といった基本的なことがらに着目して述べた。はじめに適切な研究デザインを構成しないと、その後の進展が難しくなるだろう。次回は続きとして統計モデルをとりあげたい。
人文情報学イベント関連カレンダー
【2026年11月】
-
2026-11-3 (Tue)
東京国際エジプト学セミナーhttps://docs.google.com/forms/d/e/1FAIpQLScKw47iFbrKIe8fefJrg2oCOrZb_cvnV91GmSUnx_q3aYg02w/viewform
於・東京大学本郷キャンパス -
2026-11-3 (Tue), 12 (Thu), 17 (Tue), 26 (Thu)
TEI 研究会於・オンライン -
2026-11-7 (Sat) ~ 2026-11-8 (Sun)
デジタルアーカイブ学会第11回研究大会https://taikai.digitalarchivejapan.org/11th/
於・近畿大学東大阪キャンパス -
2026-11-10 (Tue)
「みんなで翻刻」ワークショップhttps://www.tulips.tsukuba.ac.jp/lib/ja/information/20261027
於・筑波大学中央図書館 -
2026-11-10 (Tue)
国際シンポジウム「人文学における研究データ管理:課題,実践,研究支援」於・うめきたSHIPホール -
2026-11-14 (Sat)
2026年度JCAS年次集会・一般公開シンポジウムhttps://www.aa.tufs.ac.jp/events/detail/e530/
於・東京外国語大学アジア・アフリカ言語文化研究所およびオンライン -
2026-11-15 (Sun)
「アラビア文字テキストと TEI」シンポジウムhttps://docs.google.com/forms/d/e/1FAIpQLScJKxt7OAv3ppJVmj3NqhKcw2dfnOTFpVAwbRwjueDumsf1Kg/viewform
於・甲南大学ネットワークキャンパス東京およびオンライン -
2026-11-16 (Mon) ~ 2026-11-20 (Fri)
ICOM-DOCUMENTATION 2026https://icomdocumentation2026.africamuseum.be/
於・AfricaMuseum (Tervuren, Belgium) -
2026-11-24 (Tue)
デジタルアーカイブ学会第11回研究大会サテライト企画 Japan-Europe cross talk #3https://www.eajrs.net/japan-europe-cross-talk-3
於・オンライン -
2026-11-28 (Sat) ~ 2026-11-29 (Sun)
The First International Conference of the Japan Liaison Council for Oriental and Asian Studieshttps://sites.google.com/tohogakkai.jp/j-coas2026/english
於・東京大学本郷キャンパス
【2026年12月】
-
2026-12-1 (Tue), 10 (Thu), 15 (Tue), 24 (Thu), 29 (Tue)
TEI 研究会於・オンライン -
2026-12-2 (Wed) ~ 2026-12-4 (Fri)
ICADL 2026: The 28th International Conference on Asia-Pacific Digital Librarieshttps://easychair.org/cfp/icadl2026
於・Khon Kaen University(Khonkaen, Thailand) -
2026-12-5 (Sat) ~ 2026-12-9 (Wed)
東北大学国際シンポジウム「AI とデジタル・ヒューマニティーズ」https://cijs.oii.tohoku.ac.jp/news/detail---id-196.html
於・東北大学片平キャンパス -
2026-12-9 (Wed)
国文研 DDH プロジェクト第2回国際研究集会「研究基盤としてのテキスト─夢の書庫を築く─」https://www.nijl.ac.jp/event-info/2026ddh_2_conference/
於・国文学研究資料館 -
2026-12-12 (Sat) ~ 2026-12-13 (Sun)
人文科学とコンピュータシンポジウム「じんもんこん2026」https://jinmoncom.jp/sympo2026/index.html
於・京都大学吉田キャンパス
【2027年1月】
-
2027-1-7 (Thu), 12 (Tue), 21 (Thu), 26 (Tue)
TEI 研究会於・オンライン -
2027-1-21 (Thu) ~ 2027-1-24 (Sun)
Hong Kong Association for Digital Humanities Annual Conference於・The Education University of Hong Kong
Digital Humanities Events カレンダー共同編集人
◆編集後記
先日、「PHP の脆弱性」により、世界各地で一斉に Web サービスが停止するという事態がありました。対処が遅れたり、対処ができなくてサービス自体がなくなったり、といったこともあり、Web サービスに依拠することの大変さが改めて広く周知されたように思います。このような状況にデジタル・ヒューマニティーズ分野の成果がどう対応すべきなのか、ということについては、今年、バンクーバーで開催された TEI 協会の年次大会、TEI2026において一つの回答が広まりつつあることを実感したところです。
カナダのヴィクトリア大学による Endings プロジェクトは、人文学系教員、プログラマ、図書館員が共同で進めた研究プロジェクトです。200件を超えるプロジェクトを支援してきた同大学の DH のセンターで保守負担が限界に達したことが出発点とのことです。すなわち、「DH プロジェクトはどのように終わるのか、どのように終わるべきか」という課題に対して、デジタル成果物を長期に利用可能にするための原則を作成・公表しています。
ここでは Endings 原則を掲げていますが、その核心は、高度な保守を続ける体制の構築を求めるのではなく、なるべく保守を必要としない形に成果物を整えることです。つまり、図書館ではソフトウェアも含めた動的なサイトの保存は困難ですが、静的なサイトなら保持できる、ということです。この原則は、データ、文書化、処理、成果物、リリース管理の五分野から成っています。TEI/XML などオープン標準の形式でデータを保存して版管理をすること、データモデルと権利関係を静的な文書として成果物に同梱すること、入出力を検証してエラーがあれば処理を止めること、サーバ側のソフトウェアや外部サービスに依存しない静的サイトとして成果物を構築すること、そして印刷物の版と同じように全ページにビルド日と版番号を付し、版と頁を特定して引用できるようにすることです。プログラムは長く残らないものとみなされ、データと成果物を長期保存の対象とします。
実際にヴィクトリア大学図書館は、Endings 準拠で構築された日記資料の電子版を、同館が初めてアーカイブした DH プロジェクトとして受け入れています。そして、TEI2026における複数の発表も、この Endings 準拠であることを示すバッジをスライドに載せていました。今のところは主にカナダを中心に広まりつつあるようですが、日本でも有益な面が多いように思いますので、導入を検討してみてもよいのかもしれないと思ったところでした。
